ATAC + RNA 单细胞多组学:分析指南
SeekArc 单细胞多组学数据(RNA + ATAC) 技术在同一个细胞中同时获取 染色质可及性(scATAC-seq) 与 基因表达(scRNA-seq) 两个维度的分子信息,能够在单细胞分辨率下解析"表观调控—转录输出"的因果关联。
基于 ATAC + RNA 双组学数据,不仅可以像传统单组学一样完成细胞类型注释与差异基因分析,更能进一步回答深层调控机制问题:哪些转录因子(TF)驱动了特定细胞状态?哪些顺式调控元件(CRE)在特定细胞类型中被激活?调控元件与靶基因之间的物理连接如何建立?调控网络在不同细胞类型间的异质性如何?
为帮助用户挖掘 ATAC + RNA 双组学数据的价值,寻因生物提供系统化的下游分析流程与教程,覆盖从基础质控与降维聚类,到差异可及性分析、Motif 富集,再到 Peak-Gene 关联、TF 调控三元组推断、TF Footprint 足迹分析,并提供了基于 SCENIC+ 的完整调控网络构建等经典分析内容。每个教程均明确了输入文件规范、参数配置与可解释的输出结果,帮助用户高效完成从数据到生物学机制的转化。
1. 数据预处理
使用 SeekArc® Tools 对 SeekArc 单细胞多组学数据的 RNA 文库与 ATAC 文库分别进行 Barcode 提取与矫正、序列比对与定量,联合判定细胞边界后,输出 RNA 表达矩阵、Peak 矩阵及 Fragment 文件,为下游多组学分析提供标准化的输入数据。该步骤确保 RNA 与 ATAC 数据来自同一细胞,并生成可用于后续质量控制的标准化格式文件。
2. 基础分析
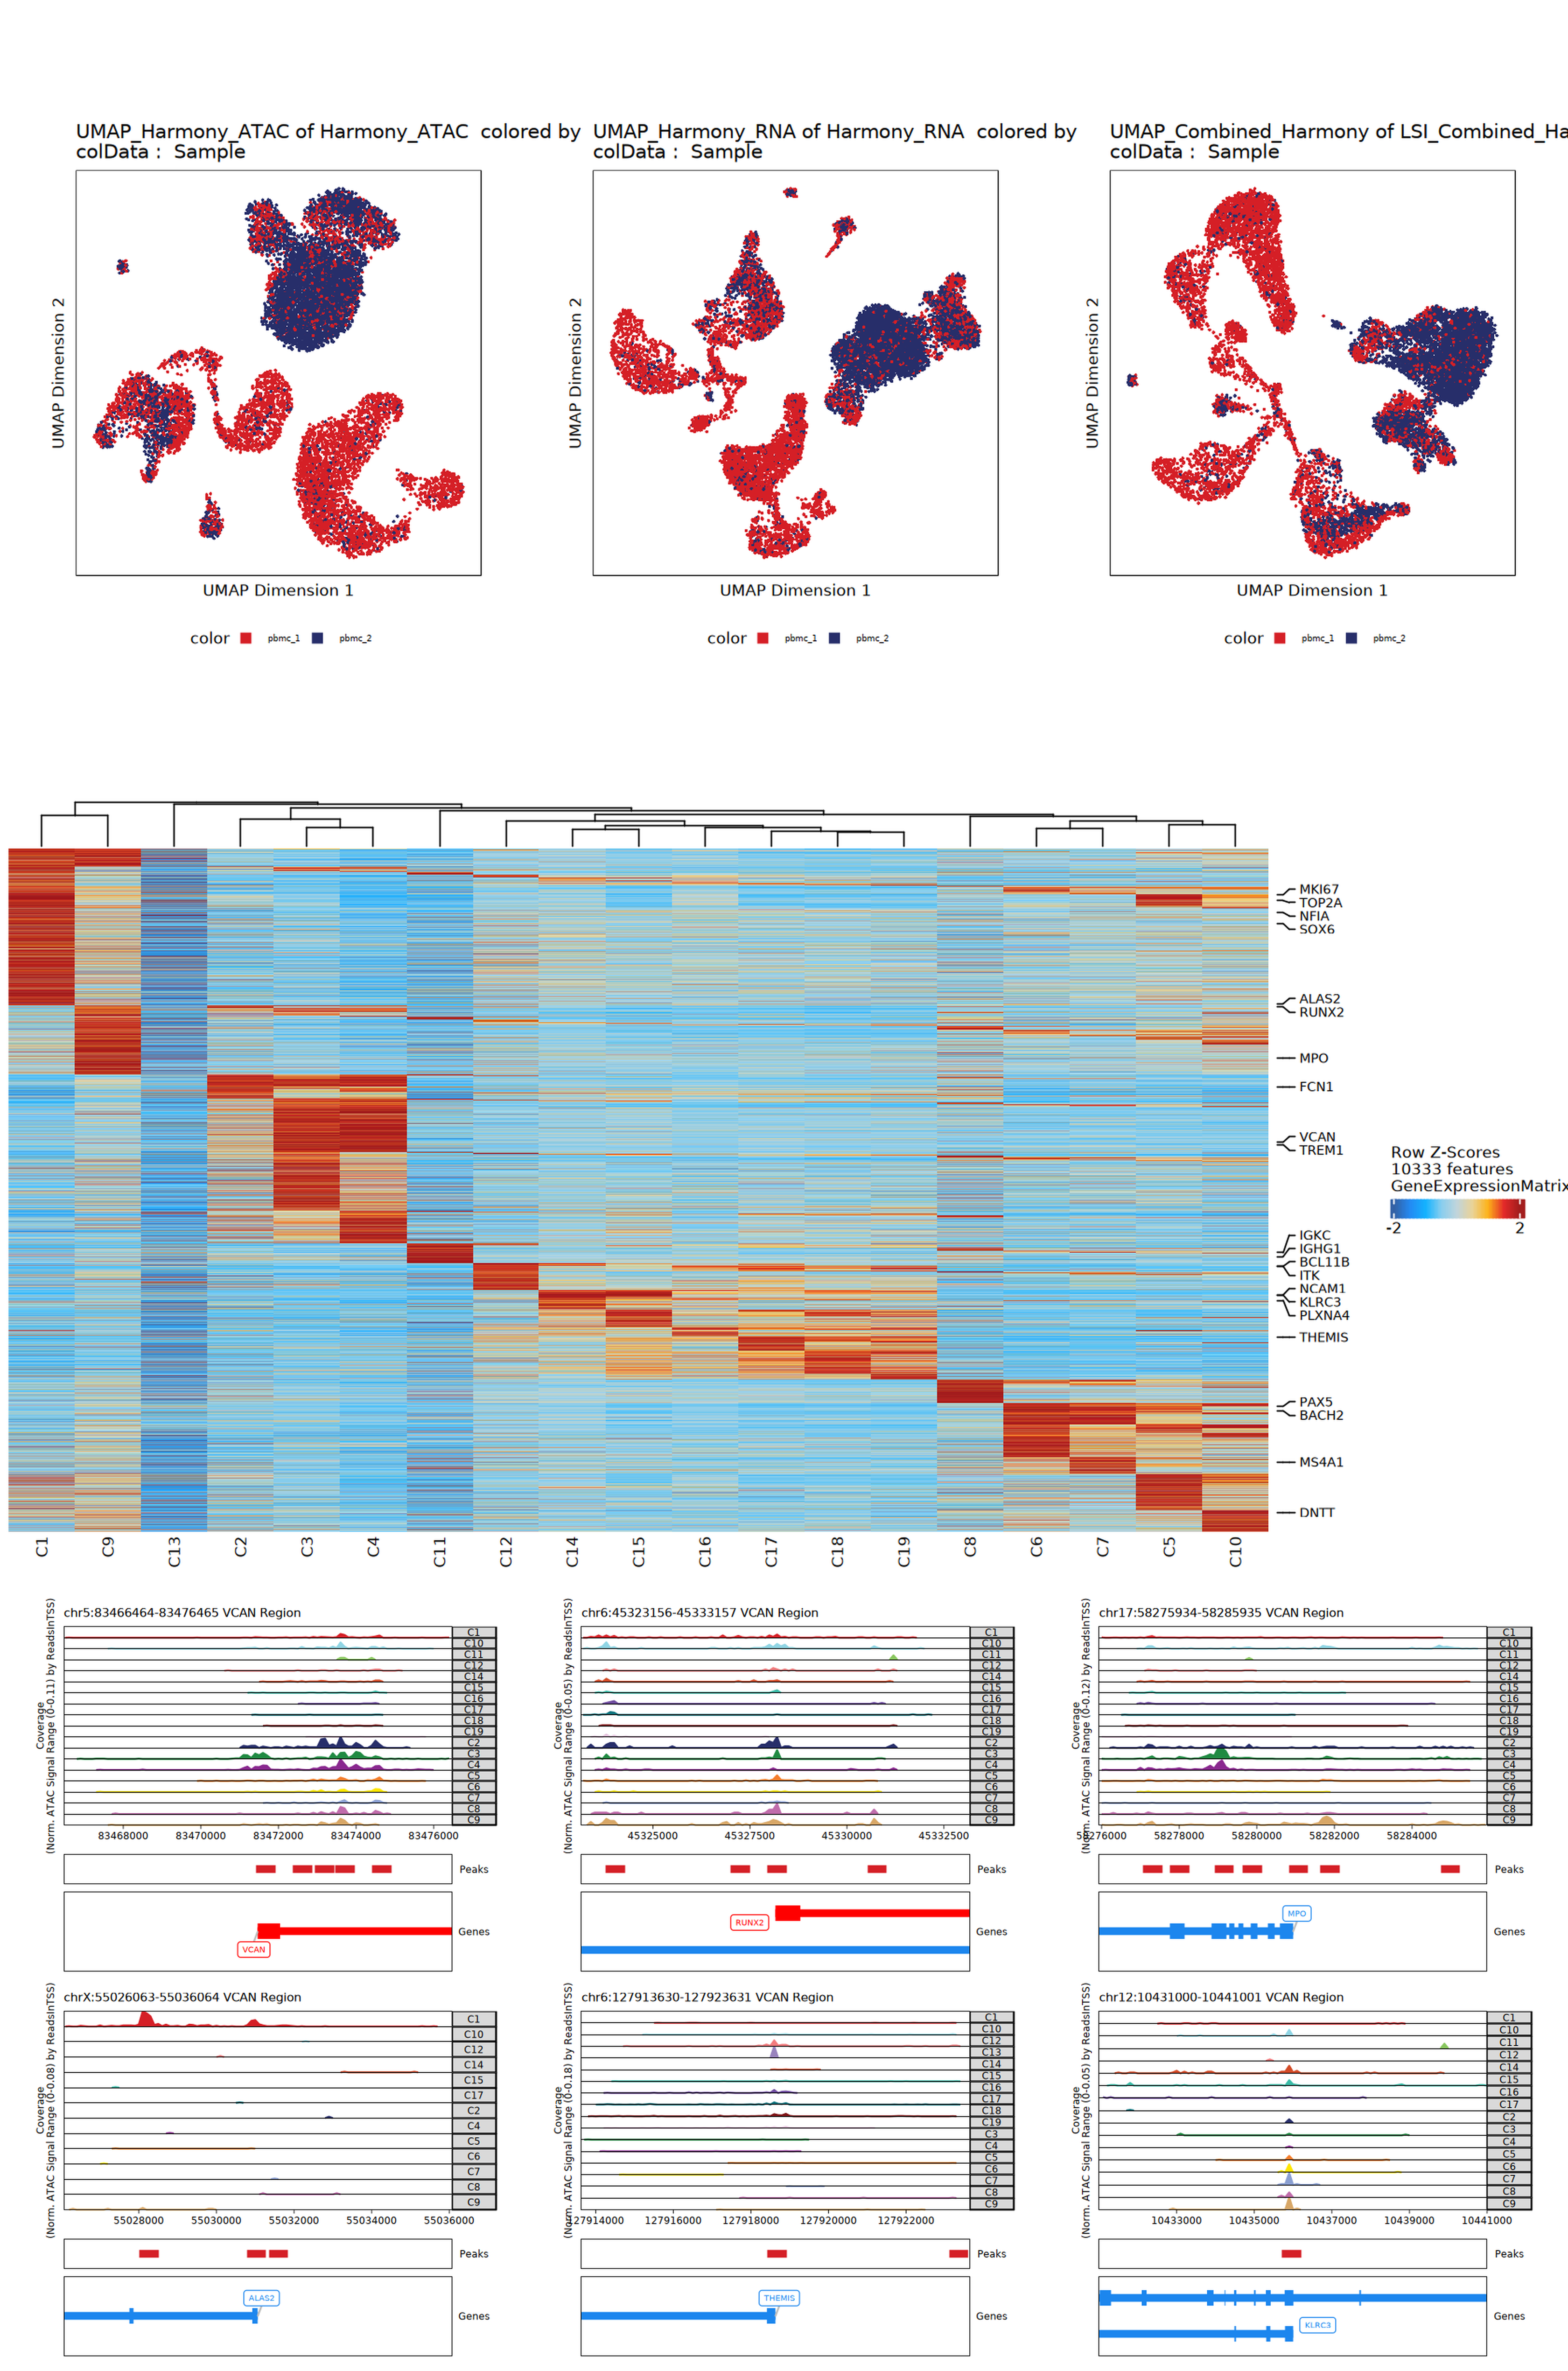
在完成数据预处理后,需进行系统的质控、降维聚类与细胞类型注释。面对不同的分析需求与编程偏好,我们提供了两条并行的基础分析路线——基于 ArchR 框架(R)与基于 Signac 框架(R),用户可根据项目规模、分析习惯与下游需求灵活选择。
ArchR 路线采用 LSI(Latent Semantic Indexing)迭代降维算法,通过构建 Tile Matrix 和 Gene Score Matrix 实现高效的内存管理,特别适合处理大规模数据集(>10 万细胞)。其优势在于内置功能完整、计算效率高,可快速完成从质控到聚类的完整流程。Signac 路线则与 Seurat 生态深度整合,支持 WNN(Weighted Nearest Neighbor)多模态联合聚类策略,能够动态评估 RNA 与 ATAC 两种模态对细胞相似性的相对贡献,从而获得更稳健的细胞分群结果。对于多样本整合场景,Signac 路线提供 CCA(Canonical Correlation Analysis)与 Harmony 两种批次校正方案,用户可根据批次效应强度选择合适策略。
无论选择哪条路线,核心分析内容均涵盖:质控过滤(基于 TSS 富集、片段数、线粒体比例等指标)、降维聚类(LSI/PCA/WNN)、批次校正(Harmony/CCA)、分组 Peak Calling(识别细胞类型特异性开放区域)及细胞类型注释(基于 marker 基因表达与染色质开放模式)。基础分析的输出结果——注释后的 ArchRProject 或 Seurat 对象——是后续所有高级分析的数据基础,其质量直接影响下游差异分析、Motif 分析及调控网络构建的可靠性。
2.1 相关教程
分析内容:涵盖质控过滤、降维聚类(LSI/WNN)、批次校正(Harmony/CCA)、分组 Peak Calling 及细胞类型注释。
2.2 输入文件
fragments.tsv.gz 及索引、filtered_feature_bc_matrix/(RNA 表达矩阵)、filtered_peaks_bc_matrix/(ATAC Peak 矩阵)、genes.gtf(基因组注释)
2.3 输出文件
注释后的 ArchRProject 或 Seurat 对象(.rds)、质控图件、UMAP 聚类图、Marker 热图、基因组浏览器轨迹图
3. 差异可及性分析
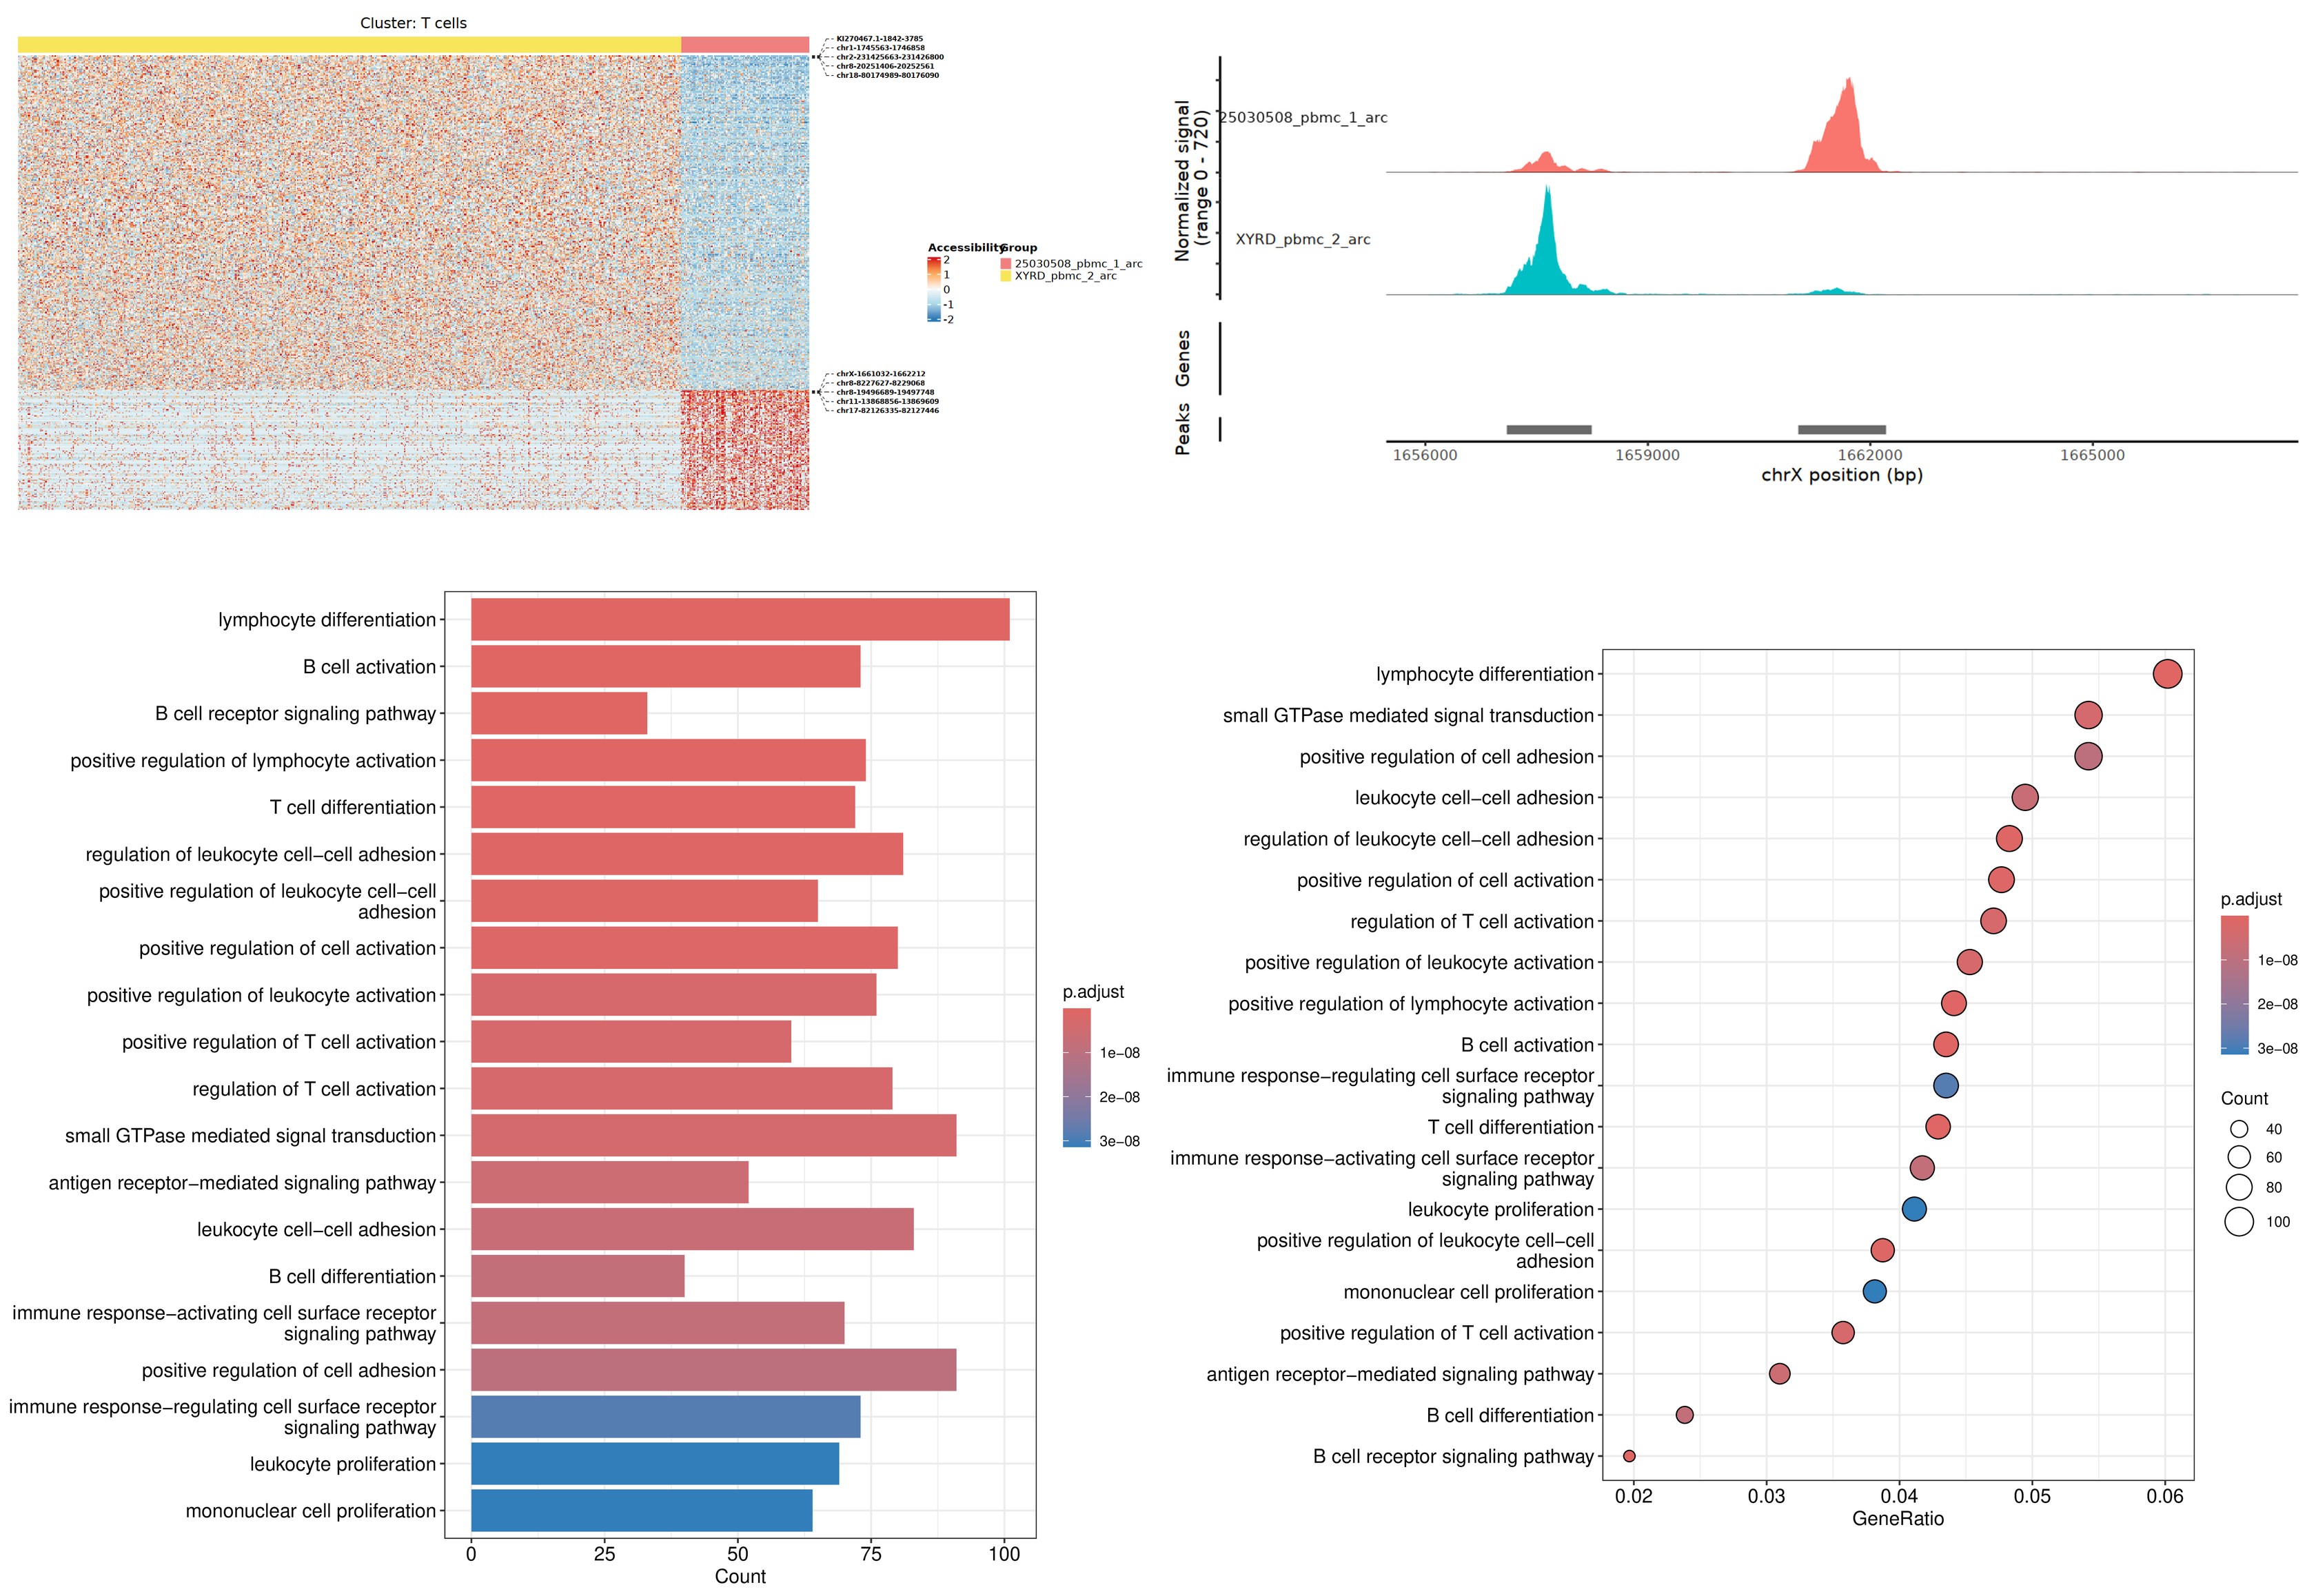
基础分析获得了完整的细胞图谱与类型注释后,下一个关键问题是:不同细胞类型之间,哪些调控元件的开放性存在显著差异?这些差异 Peak 正是定义细胞类型特异性与调控异质性的关键区域。差异可及性分析旨在系统识别不同细胞类型间或不同实验条件间的差异开放染色质区域(Differentially Accessible Peaks),揭示细胞类型特异性的调控元件。
差异可及性分析的核心目标是鉴定在特定细胞状态或实验条件下发生显著染色质重塑的基因组区域。这些差异 Peak 往往富集于增强子、启动子等顺式调控元件,是理解细胞身份维持与状态转变的关键。本分析支持两种比较模式:Cluster vs All 模式用于识别定义特定细胞类型的专属开放区域(Cluster-specific Marker Peaks),适用于细胞类型异质性解析;Case vs Control 模式则在同一细胞类型内部比较不同实验组间的差异,适用于探索疾病、药物处理或发育阶段对染色质可及性的影响。
分析方法采用 presto::wilcoxauc 进行高效的 Wilcoxon 秩和检验,结合多重检验校正(BH 方法)控制假发现率。筛选出的显著差异 Peak 通过 ClosestFeature 函数映射至邻近基因,建立从非编码区开放变化到潜在靶基因调控的初步关联。进一步整合 GO/KEGG 功能富集分析,将表观遗传层面的染色质开放性变化转化为可解释的生物学过程与信号通路,为后续 Motif 分析与调控网络构建提供候选调控元件列表。
3.1 相关教程
- 差异可及性分析与富集:ATAC + RNA 多组学:差异可及性分析(ATAC_DiffEnrich)
分析内容:涵盖差异 Peak 识别与多重检验校正、差异 Peak 的功能注释,具体是将peak最近的基因做 GO/KEGG 功能富集分析及热图可视化。
3.2 输入文件
经基础分析注释的 Seurat 对象(.rds,包含 ATAC assay 与细胞类型注释)、Fragment 文件目录
3.3 输出文件
差异 Peak 统计表(含 log2FC、FDR、关联基因)、热图、GO/KEGG 富集分析结果
4. Motif 分析
差异可及性分析回答了"哪些区域开放程度不同",但尚未回答"是什么驱动了这些差异"。转录因子结合位点(Transcription Factor Binding Site, TFBS)的 Motif 富集分析正是追溯上游调控因子的关键步骤,能够揭示这些差异开放 Peak 中富集了哪些转录因子的结合模式,为上游调控机制提供线索。
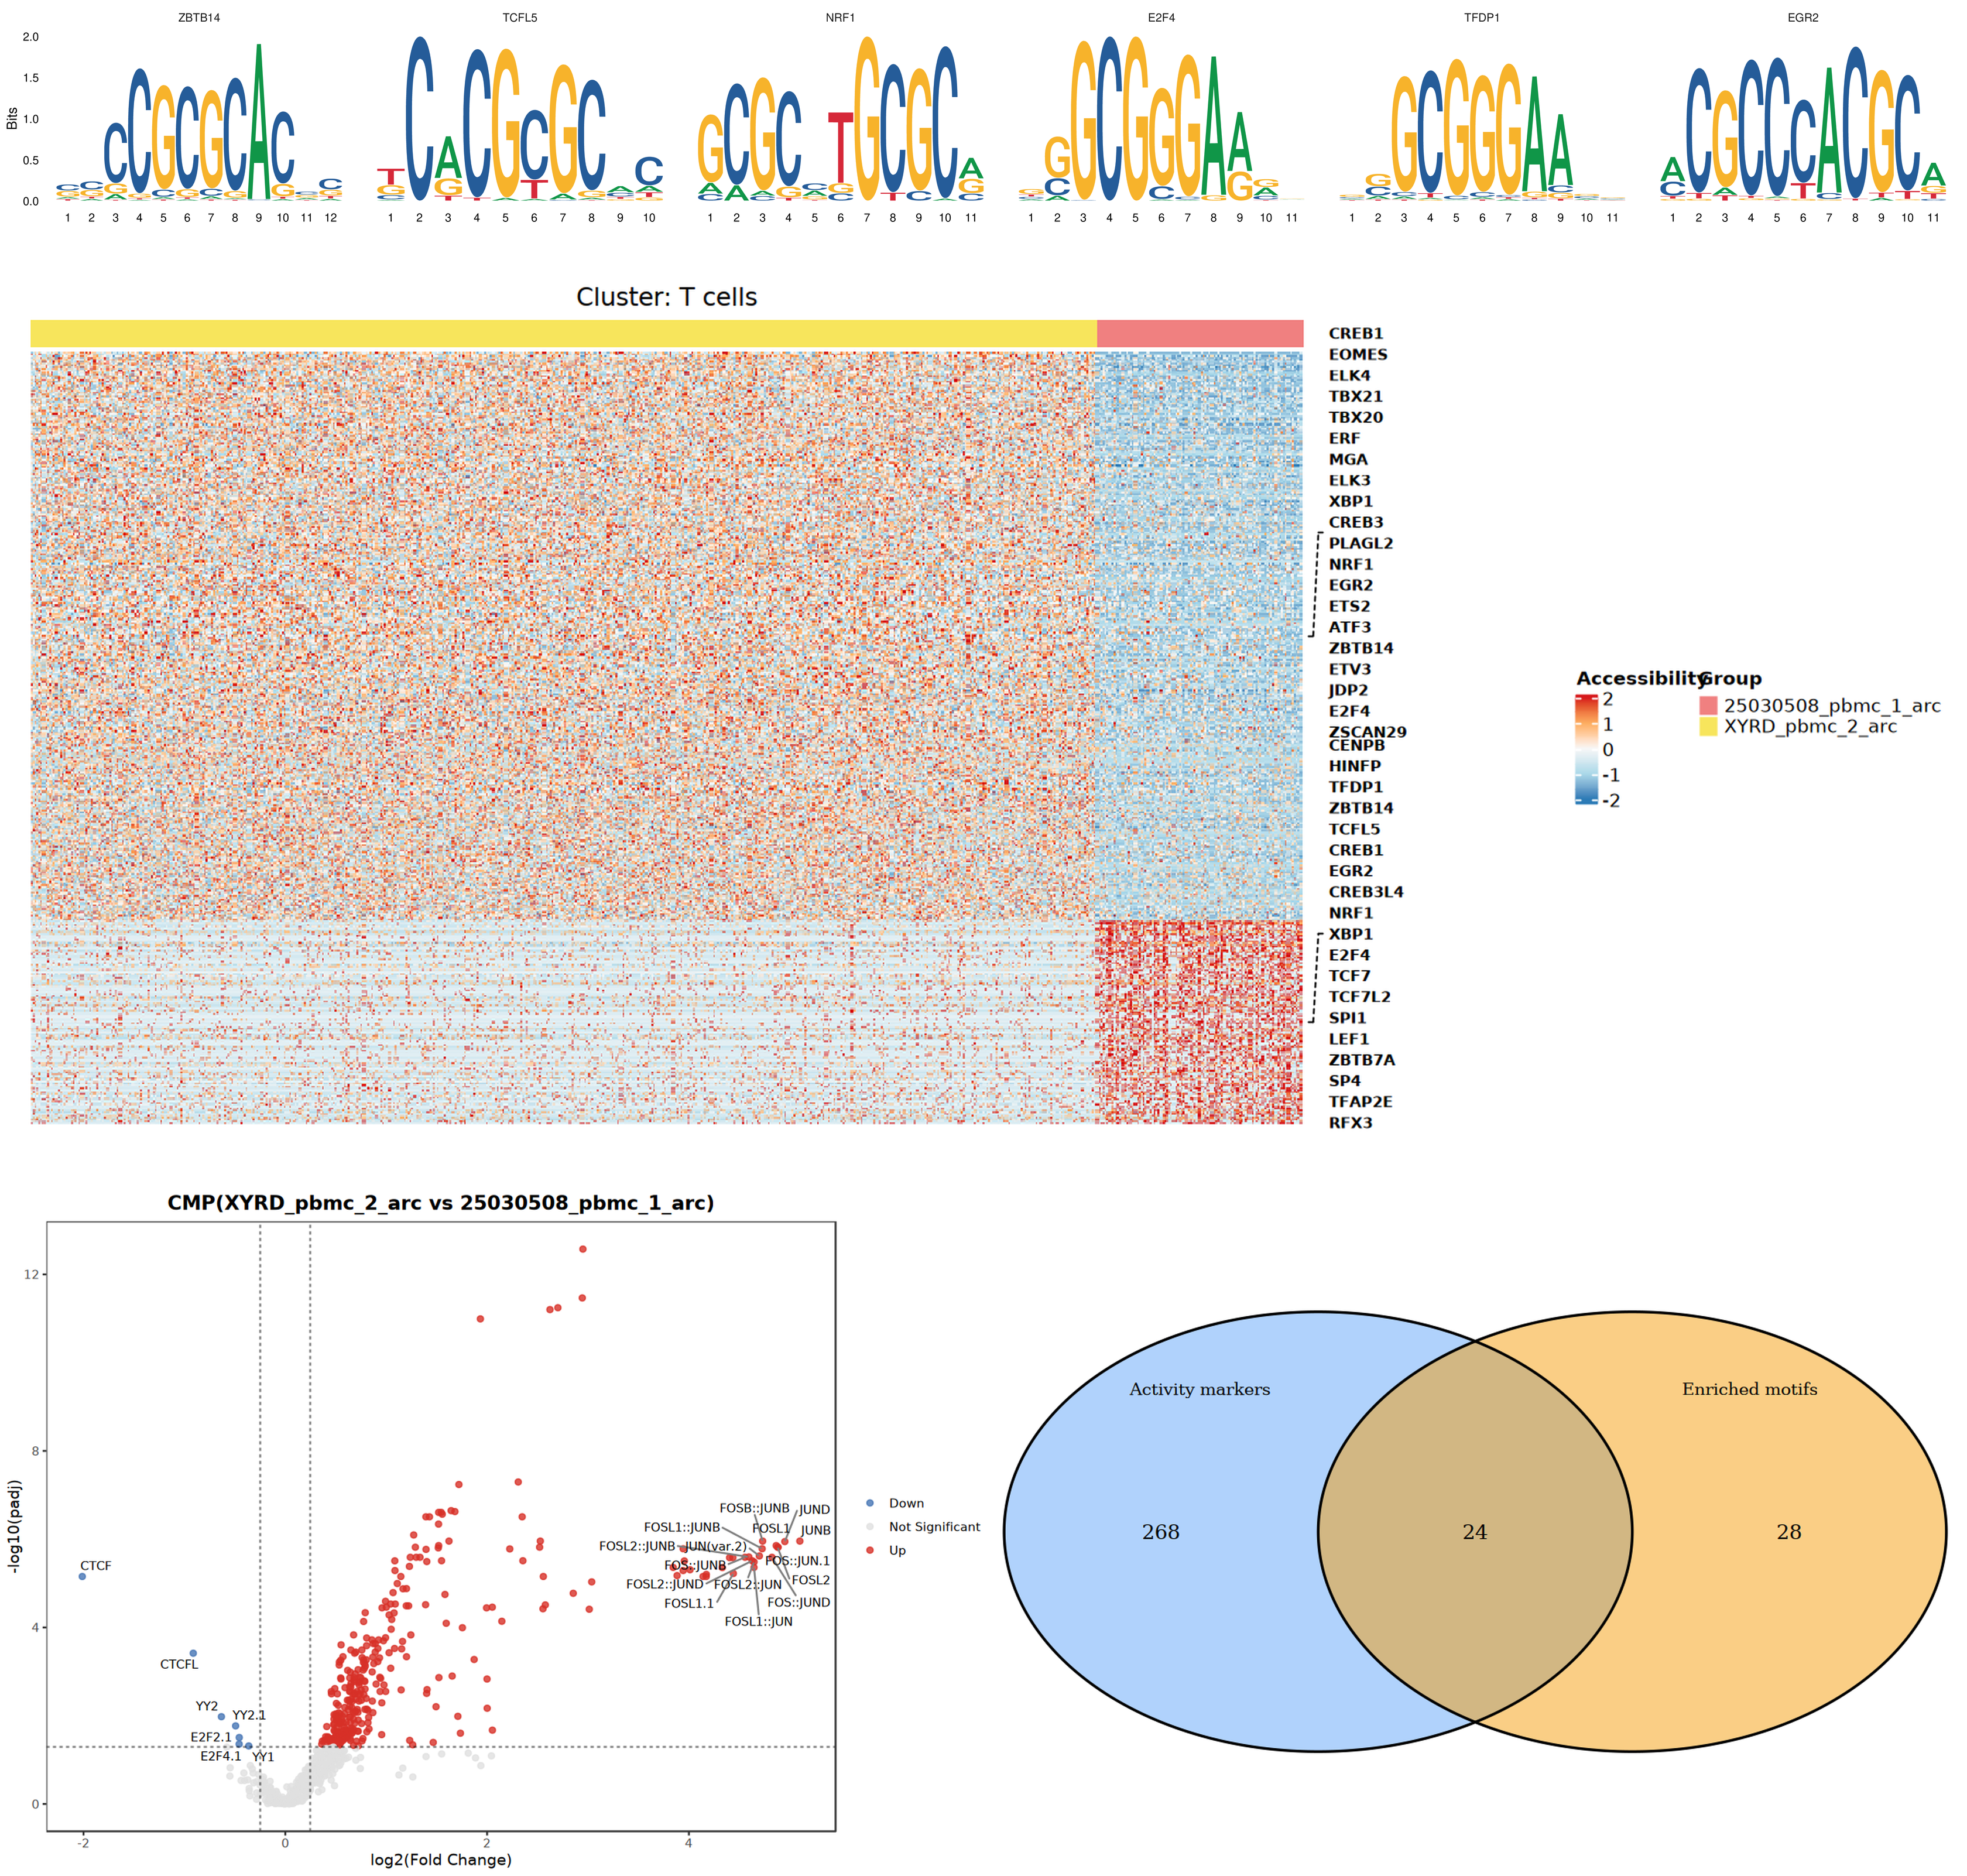
Motif 分析涵盖两个互补的分析维度:Motif 活性分析与Motif 富集分析。Motif 活性分析基于 ChromVAR 算法,通过计算单细胞全基因组范围内针对各个转录因子 Motif 的开放程度偏差值(Deviation Score),评估不同转录因子的潜在整体活性。该算法通过构建背景分布模型,校正了测序深度、GC 含量等技术偏倚,使得不同细胞间的 Motif 活性具有可比性。Motif 富集分析则针对特定的 Peak 集合(如差异开放 Peak),利用超几何检验等统计方法,检测哪些转录因子的结合位序在这些区域中显著富集,从而识别驱动特定开放模式的核心调控因子。
两种分析的结合能够提供更全面的调控图景:Motif 活性分析揭示全基因组层面的 TF 活性变化,而 Motif 富集分析聚焦于特定调控元件的 TF 结合潜力。进一步整合全局 TF 表达-活性相关性分析,可筛选出那些不仅在结合位点富集、且其 RNA 表达与染色质活性高度一致的"真实"驱动因子,显著提升调控网络推断的可靠性。
4.1 相关教程
- Motif 富集与活性分析:ATAC + RNA 多组学:Motif 分析
分析内容:涵盖 JASPAR Motif 数据库加载、ChromVAR Motif 活性评估、差异 Motif 富集及活性热图可视化。
4.2 输入文件
Seurat 对象(含 ATAC assay)、参考基因组 FASTA 文件、JASPAR/HOCOMOCO Motif 数据库
4.3 输出文件
Motif 活性矩阵、差异 Motif 富集排名、Motif 活性热图与网络图
5. Peak-to-Gene 关联分析
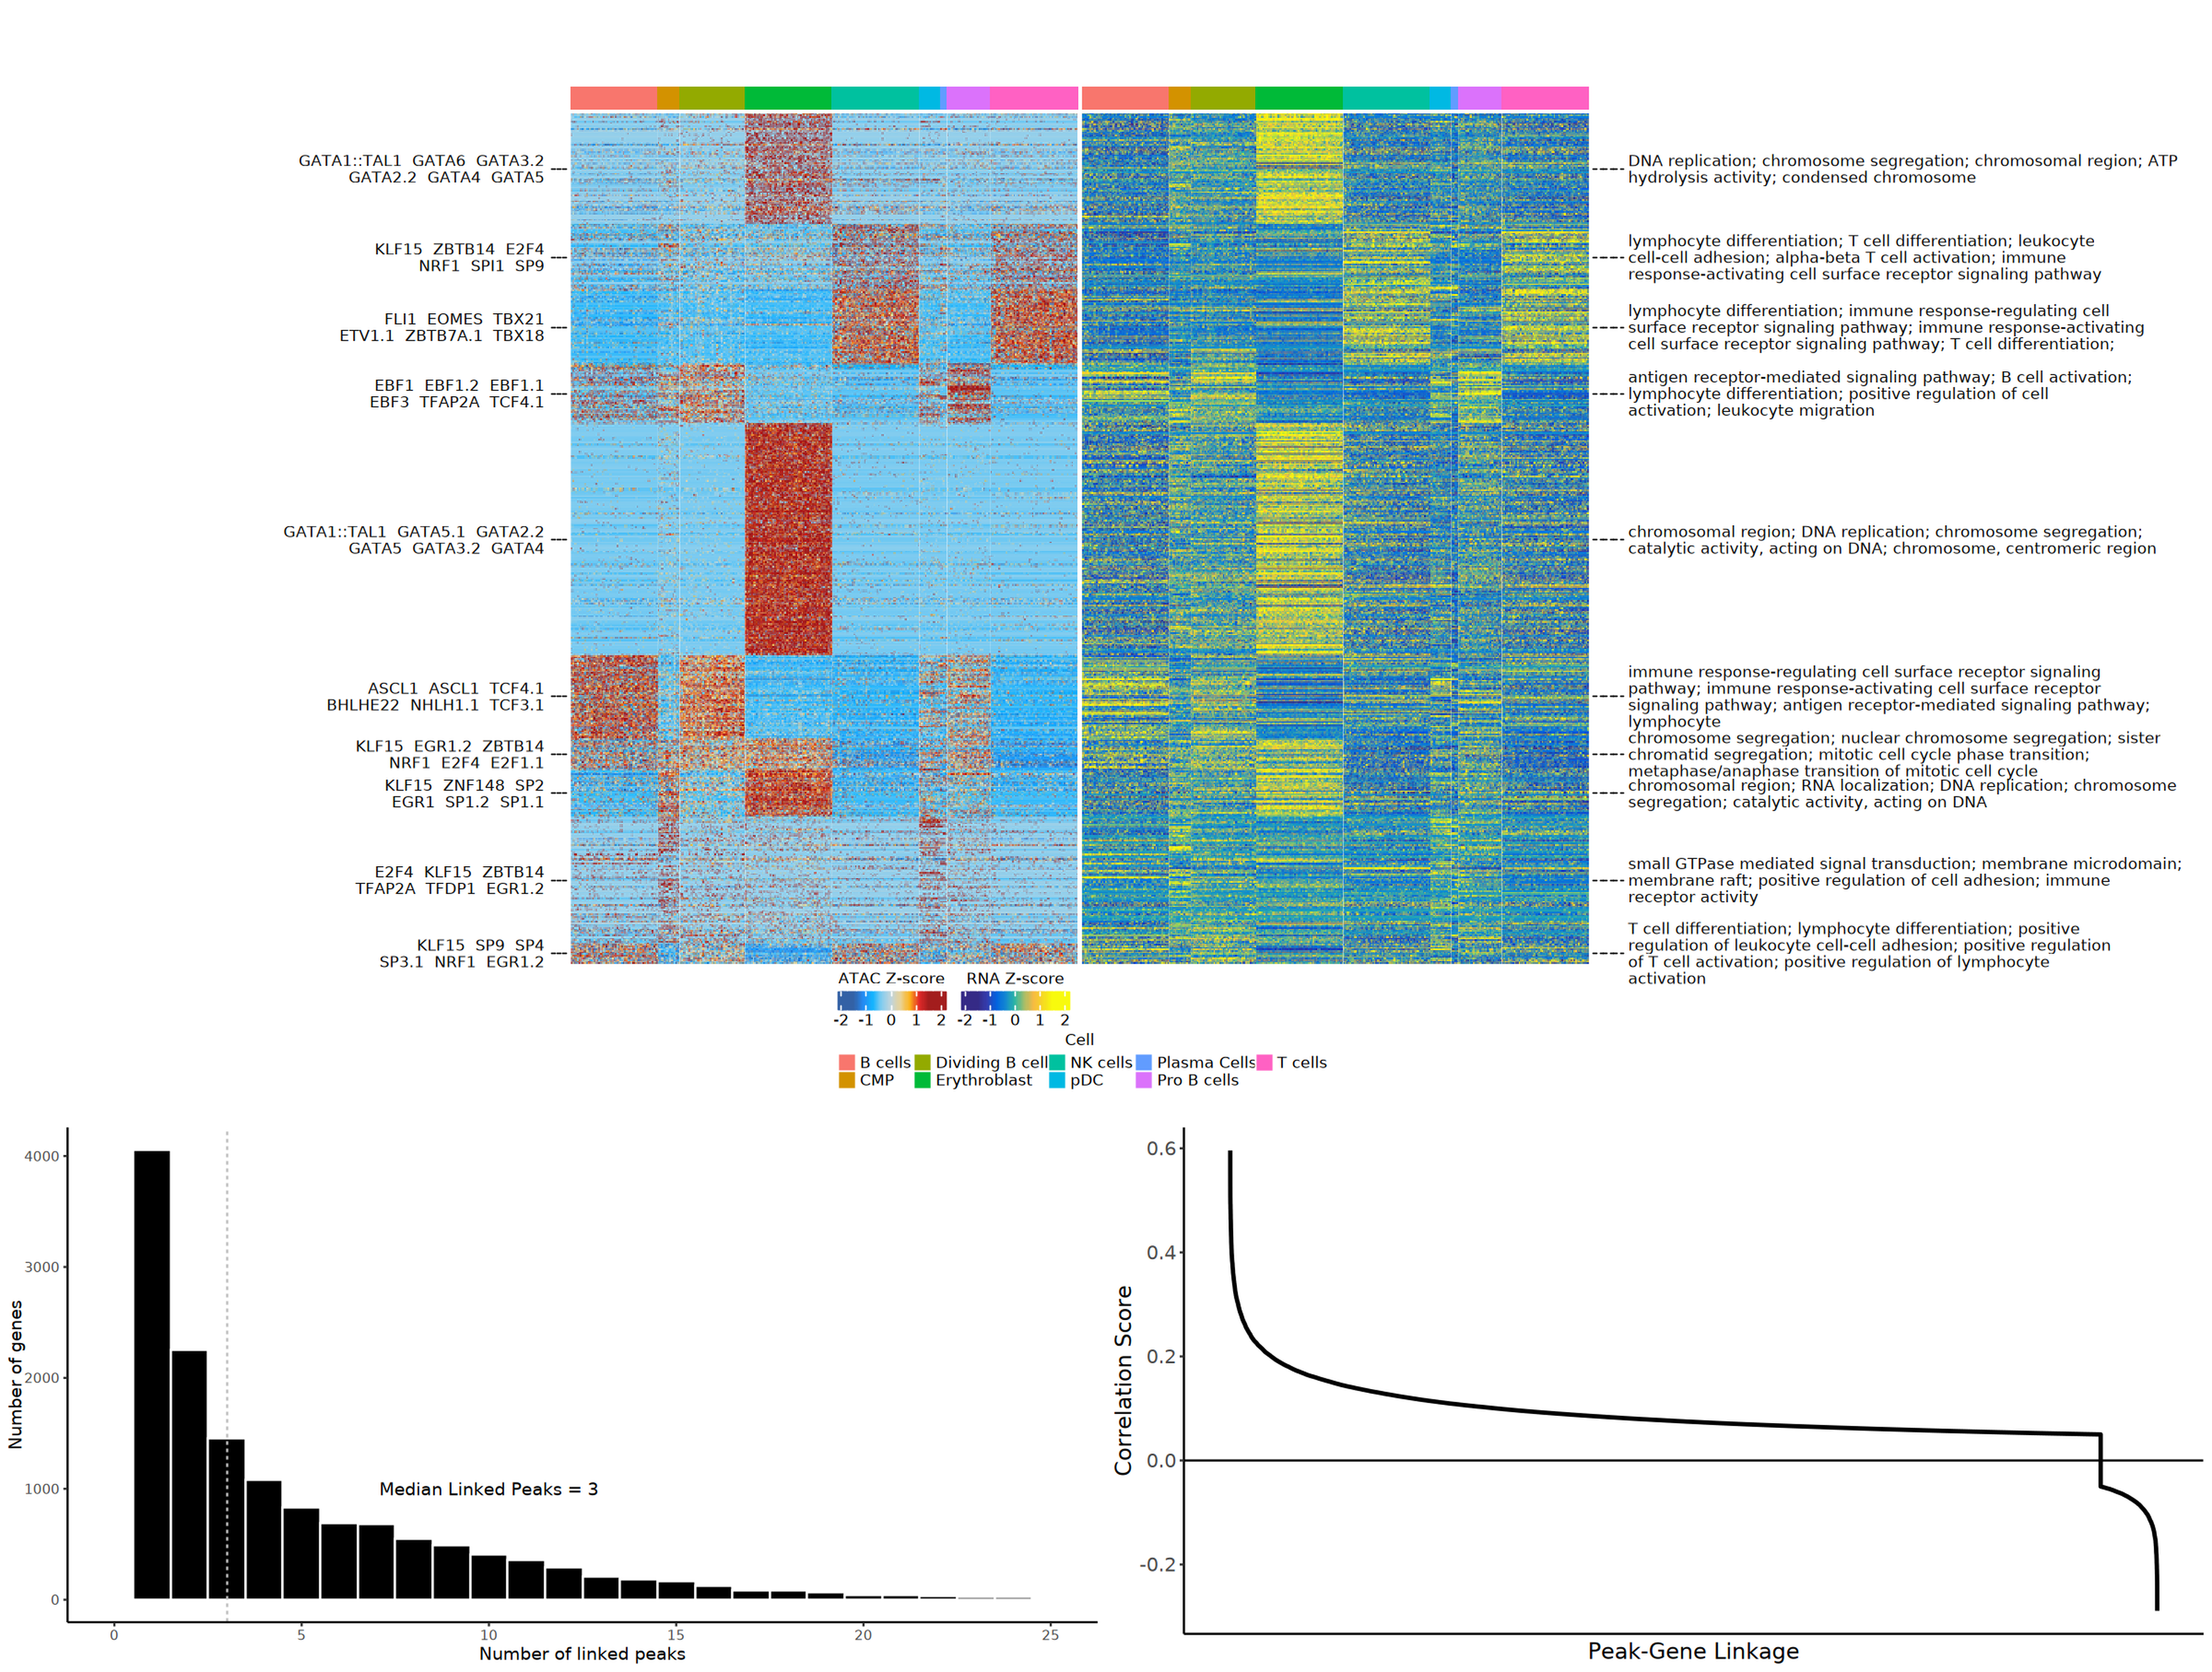
前述分析已揭示转录因子通过 Motif 与 Peak 之间的结合关系,要解析 TF 完整的调控网络,还需进一步建立 Peak 与下游基因之间的调控联系。因此,接下来需要建立 Peak(调控元件)与 Gene(靶基因)之间的物理与统计关联。通过相关性分析或基于距离的先验注释,构建调控元件-靶基因的映射关系。
Peak-Gene 关联分析的核心假设是共变性(Covariation):如果某个调控元件(Peak)的真实功能是调控特定靶基因的表达,那么在单细胞水平上,该 Peak 的染色质可及性变化应与靶基因的 mRNA 表达变化呈现显著相关性。这一假设突破了传统线性距离限制(如仅考虑 TSS 上游 1kb 区域),能够捕获通过染色质三维折叠跨越长距离调控的增强子-靶基因关系。分析采用 Signac 的 LinkPeaks 函数,计算每个 Peak 与邻近基因表达量之间的 Pearson 相关系数,并通过置换检验评估统计显著性。
为克服单细胞数据的极度稀疏性(Dropout 效应),分析流程引入Pseudobulk 策略:将同一细胞亚群内的多个细胞合并为"超细胞",通过累加计数矩阵提升信噪比,使相关性计算更加稳健。进一步通过 K-means 聚类将具有相似动态变化模式的 Peak-Gene 对划分为独立的共调控模块,并对每个模块执行 Motif 富集与 GO/KEGG 功能注释,揭示不同细胞状态下协同调控的顺式元件网络及其参与的生物学过程。
5.1 相关教程
- Peak-Gene 关联与模块分析:ATAC + RNA 多组学:Peak2Gene 分析
分析内容:涵盖 Peak-Gene 先验关联构建与相关性打分、方差过滤、K-means 共调控模块聚类及 Circos 图可视化。
5.2 输入文件
经基础分析注释的 Seurat 对象(含 RNA + ATAC 双模态数据)、参考基因组 FASTA 文件
5.3 输出文件
Gene2PeakLinks 统计表(Peak 坐标、Gene 名称、相关性得分、P 值)、调控模块聚类结果、Circos 图与热图
6. TF-Peak-Gene 三元组分析
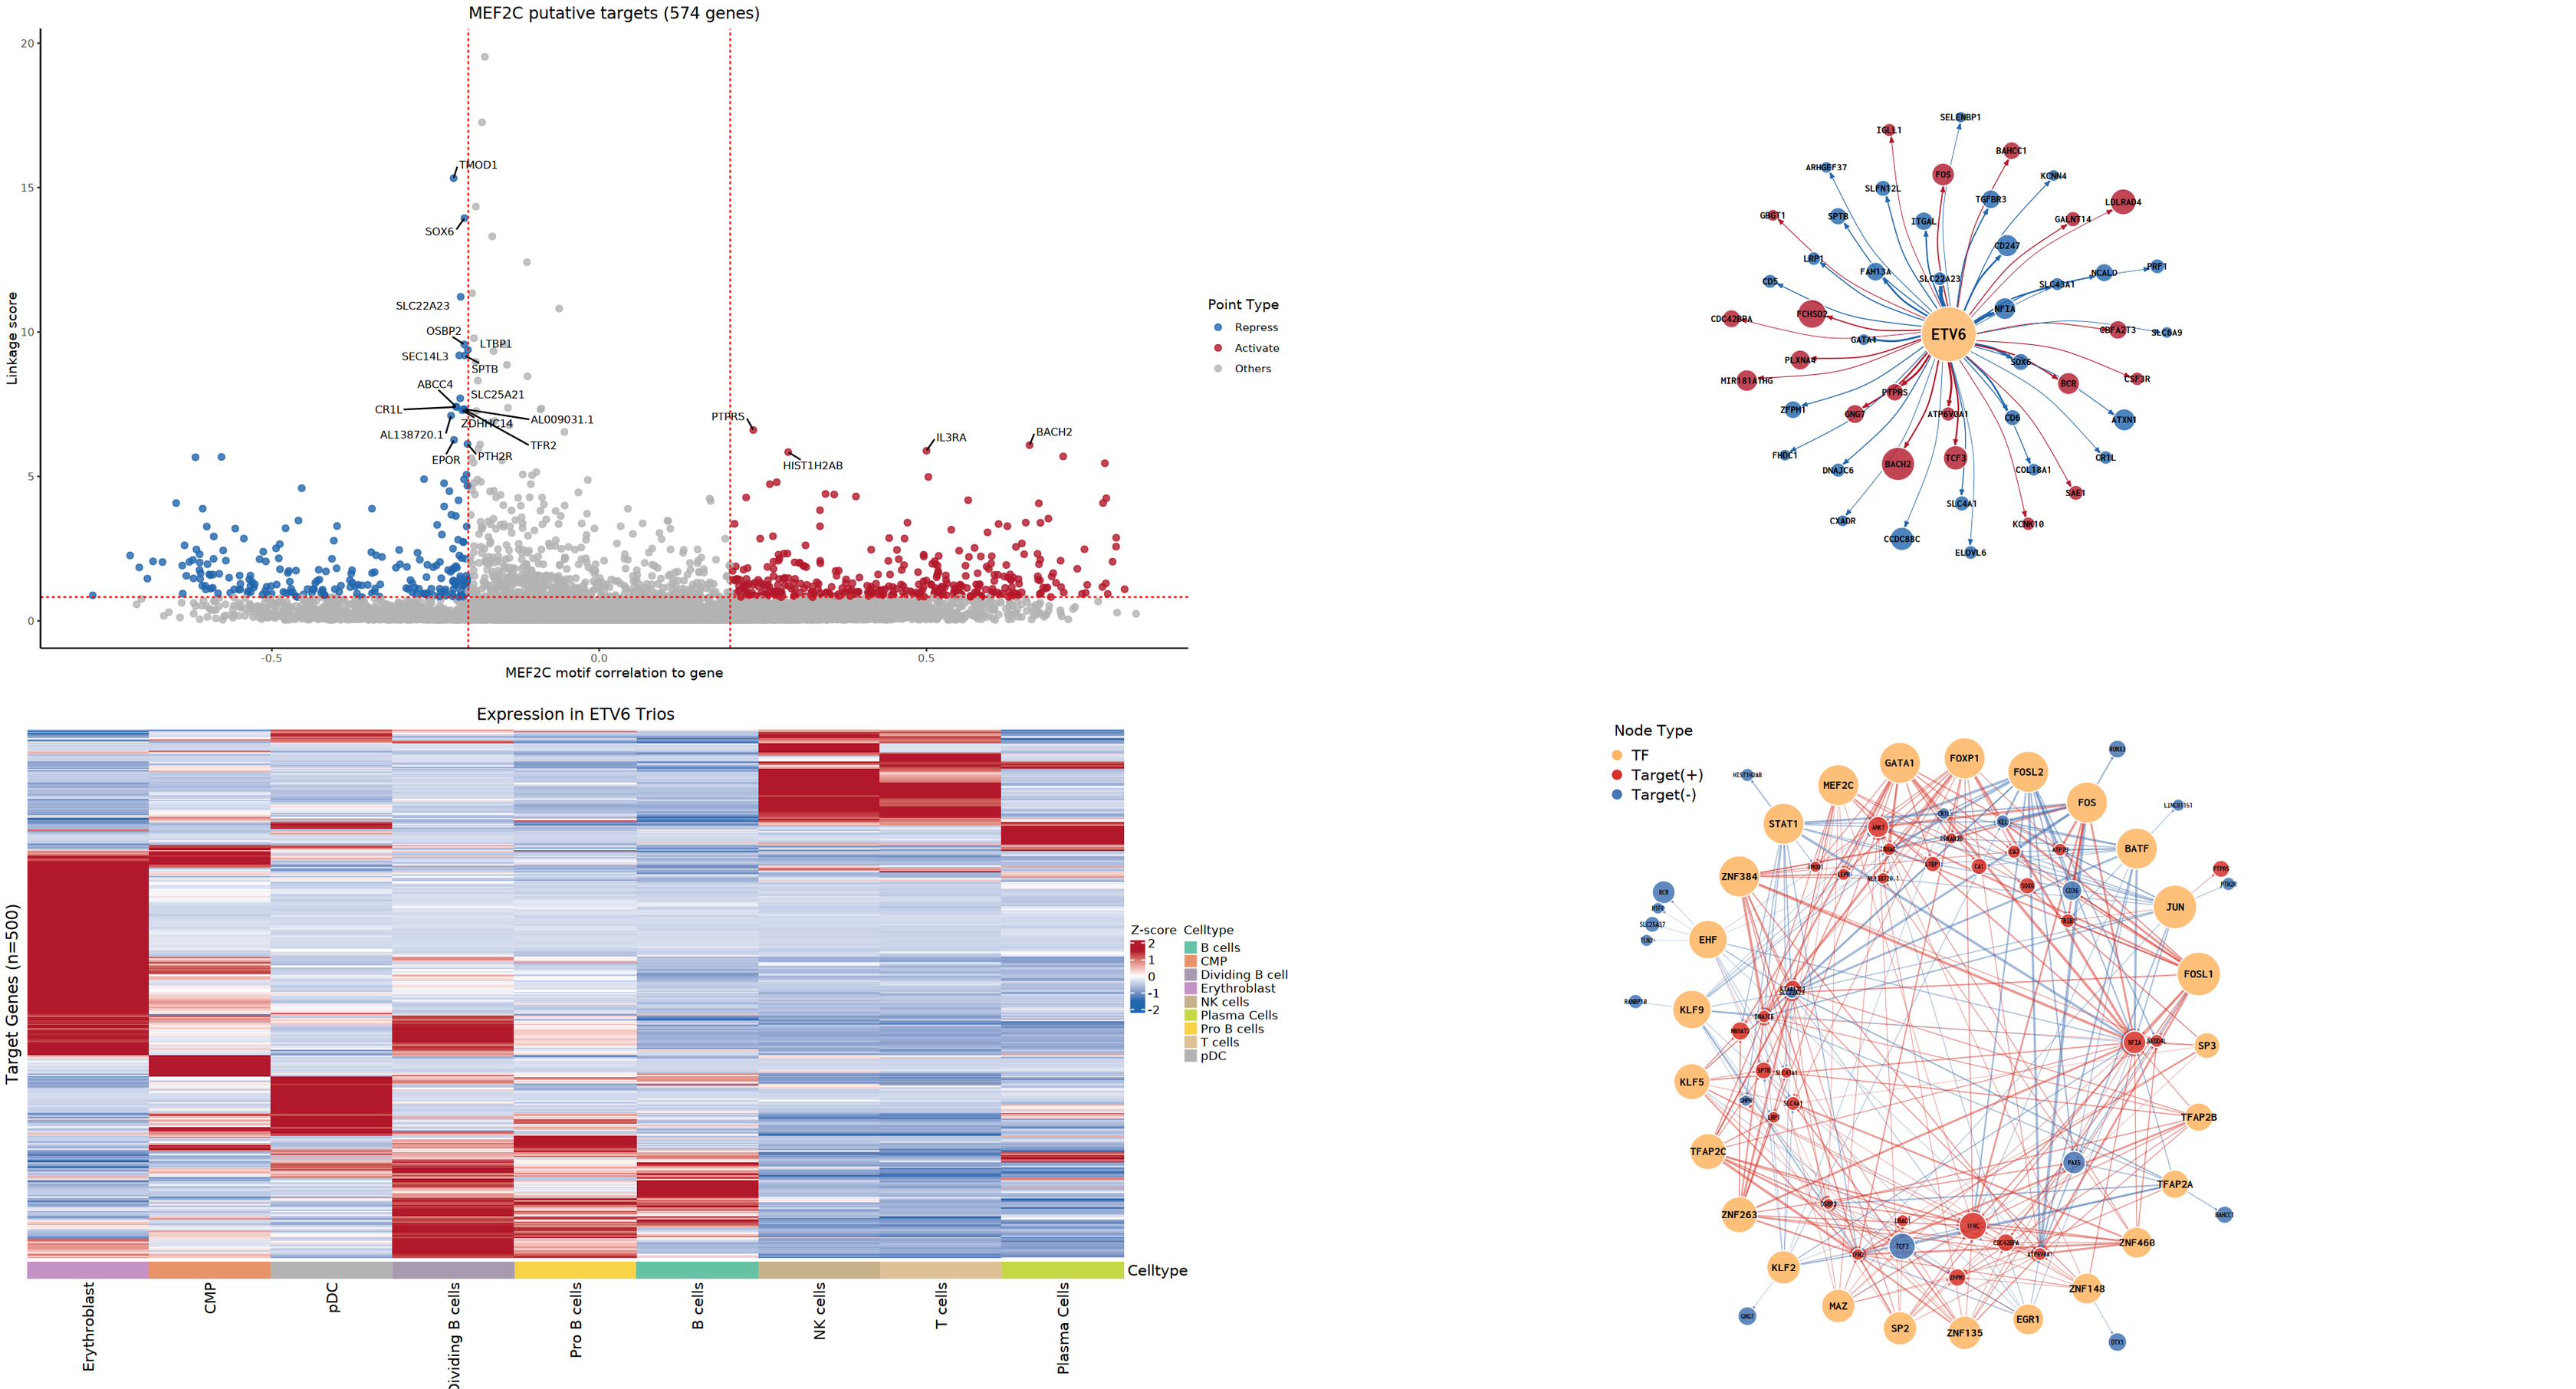
前述分析分别建立了 TF 与 Peak、Peak 与 Gene 之间的调控关系,但两者之间仍是断开的,因此需要整合 TF-Peak 和 Peak-Gene 之间的关系。三元组分析通过整合 Motif 活性、Peak-Gene 关联与 TF 表达信息,筛选同时满足以下三个条件的调控三元组:① TF 的 Motif 存在于关联 Peak 中;② Peak 与靶基因表达显著相关;③ TF 活性与靶基因表达一致性高。
三元组分析的生物学逻辑在于:真实的顺式调控网络必须在多个独立维度上同时得到验证。首先,通过基因组空间重叠分析,精确定位哪些转录因子的 Motif 结合位点落在了目标调控 Peak 内部,建立"TF → Peak"的物理绑定关系。其次,整合 Peak-to-Gene 分析结果,将 TF-Peak 连接与 Peak-Gene 连接通过共同的 Peak 进行桥接,初步构建"TF → Peak → Gene"的完整逻辑链条。最后,基于 scRNA-seq 数据执行多维过滤:计算 TF mRNA 表达量与靶基因表达量的相关性、TF ChromVAR 活性与其表达的一致性、以及 TF 活性与靶基因表达的共变性,仅保留同时通过三重检验的高置信度调控关系。
为量化多点联合调控的总强度,分析引入Linkage Score指标:将同一 TF 作用于同一靶基因所有 Peak 上的独立贡献度(Peak-Gene 相关系数平方 × Motif Score)进行累加。Linkage Score 越高,代表该 TF 调控目标基因的综合物理证据越确凿,是后续筛选核心调控骨架的最重要依据。通过这种层层递进的过滤策略,三元组分析能够从海量候选关系中剥离背景噪音,输出具有高度生物学解释力的转录调控网络。
6.1 相关教程
- TF 调控三元组推断:ATAC + RNA 多组学:TF-Peaks-Genes三元调控网络分析(Trios)
分析内容:涵盖 Motif-Peak 匹配与 Peak-Gene 链接导入、多维过滤(Motif Score/表达相关性/活性一致性)、三元组组装及网络图可视化。
6.2 输入文件:
Motif 分析结果(Motif 活性矩阵)、Peak2Gene Links 文件(Gene2PeakLinks.xls)、细胞类型注释
6.3 输出文件
TF-Peak-Gene 三元组统计表、三元组网络图、细胞类型特异性调控关系图
7. TF Footprint 分析
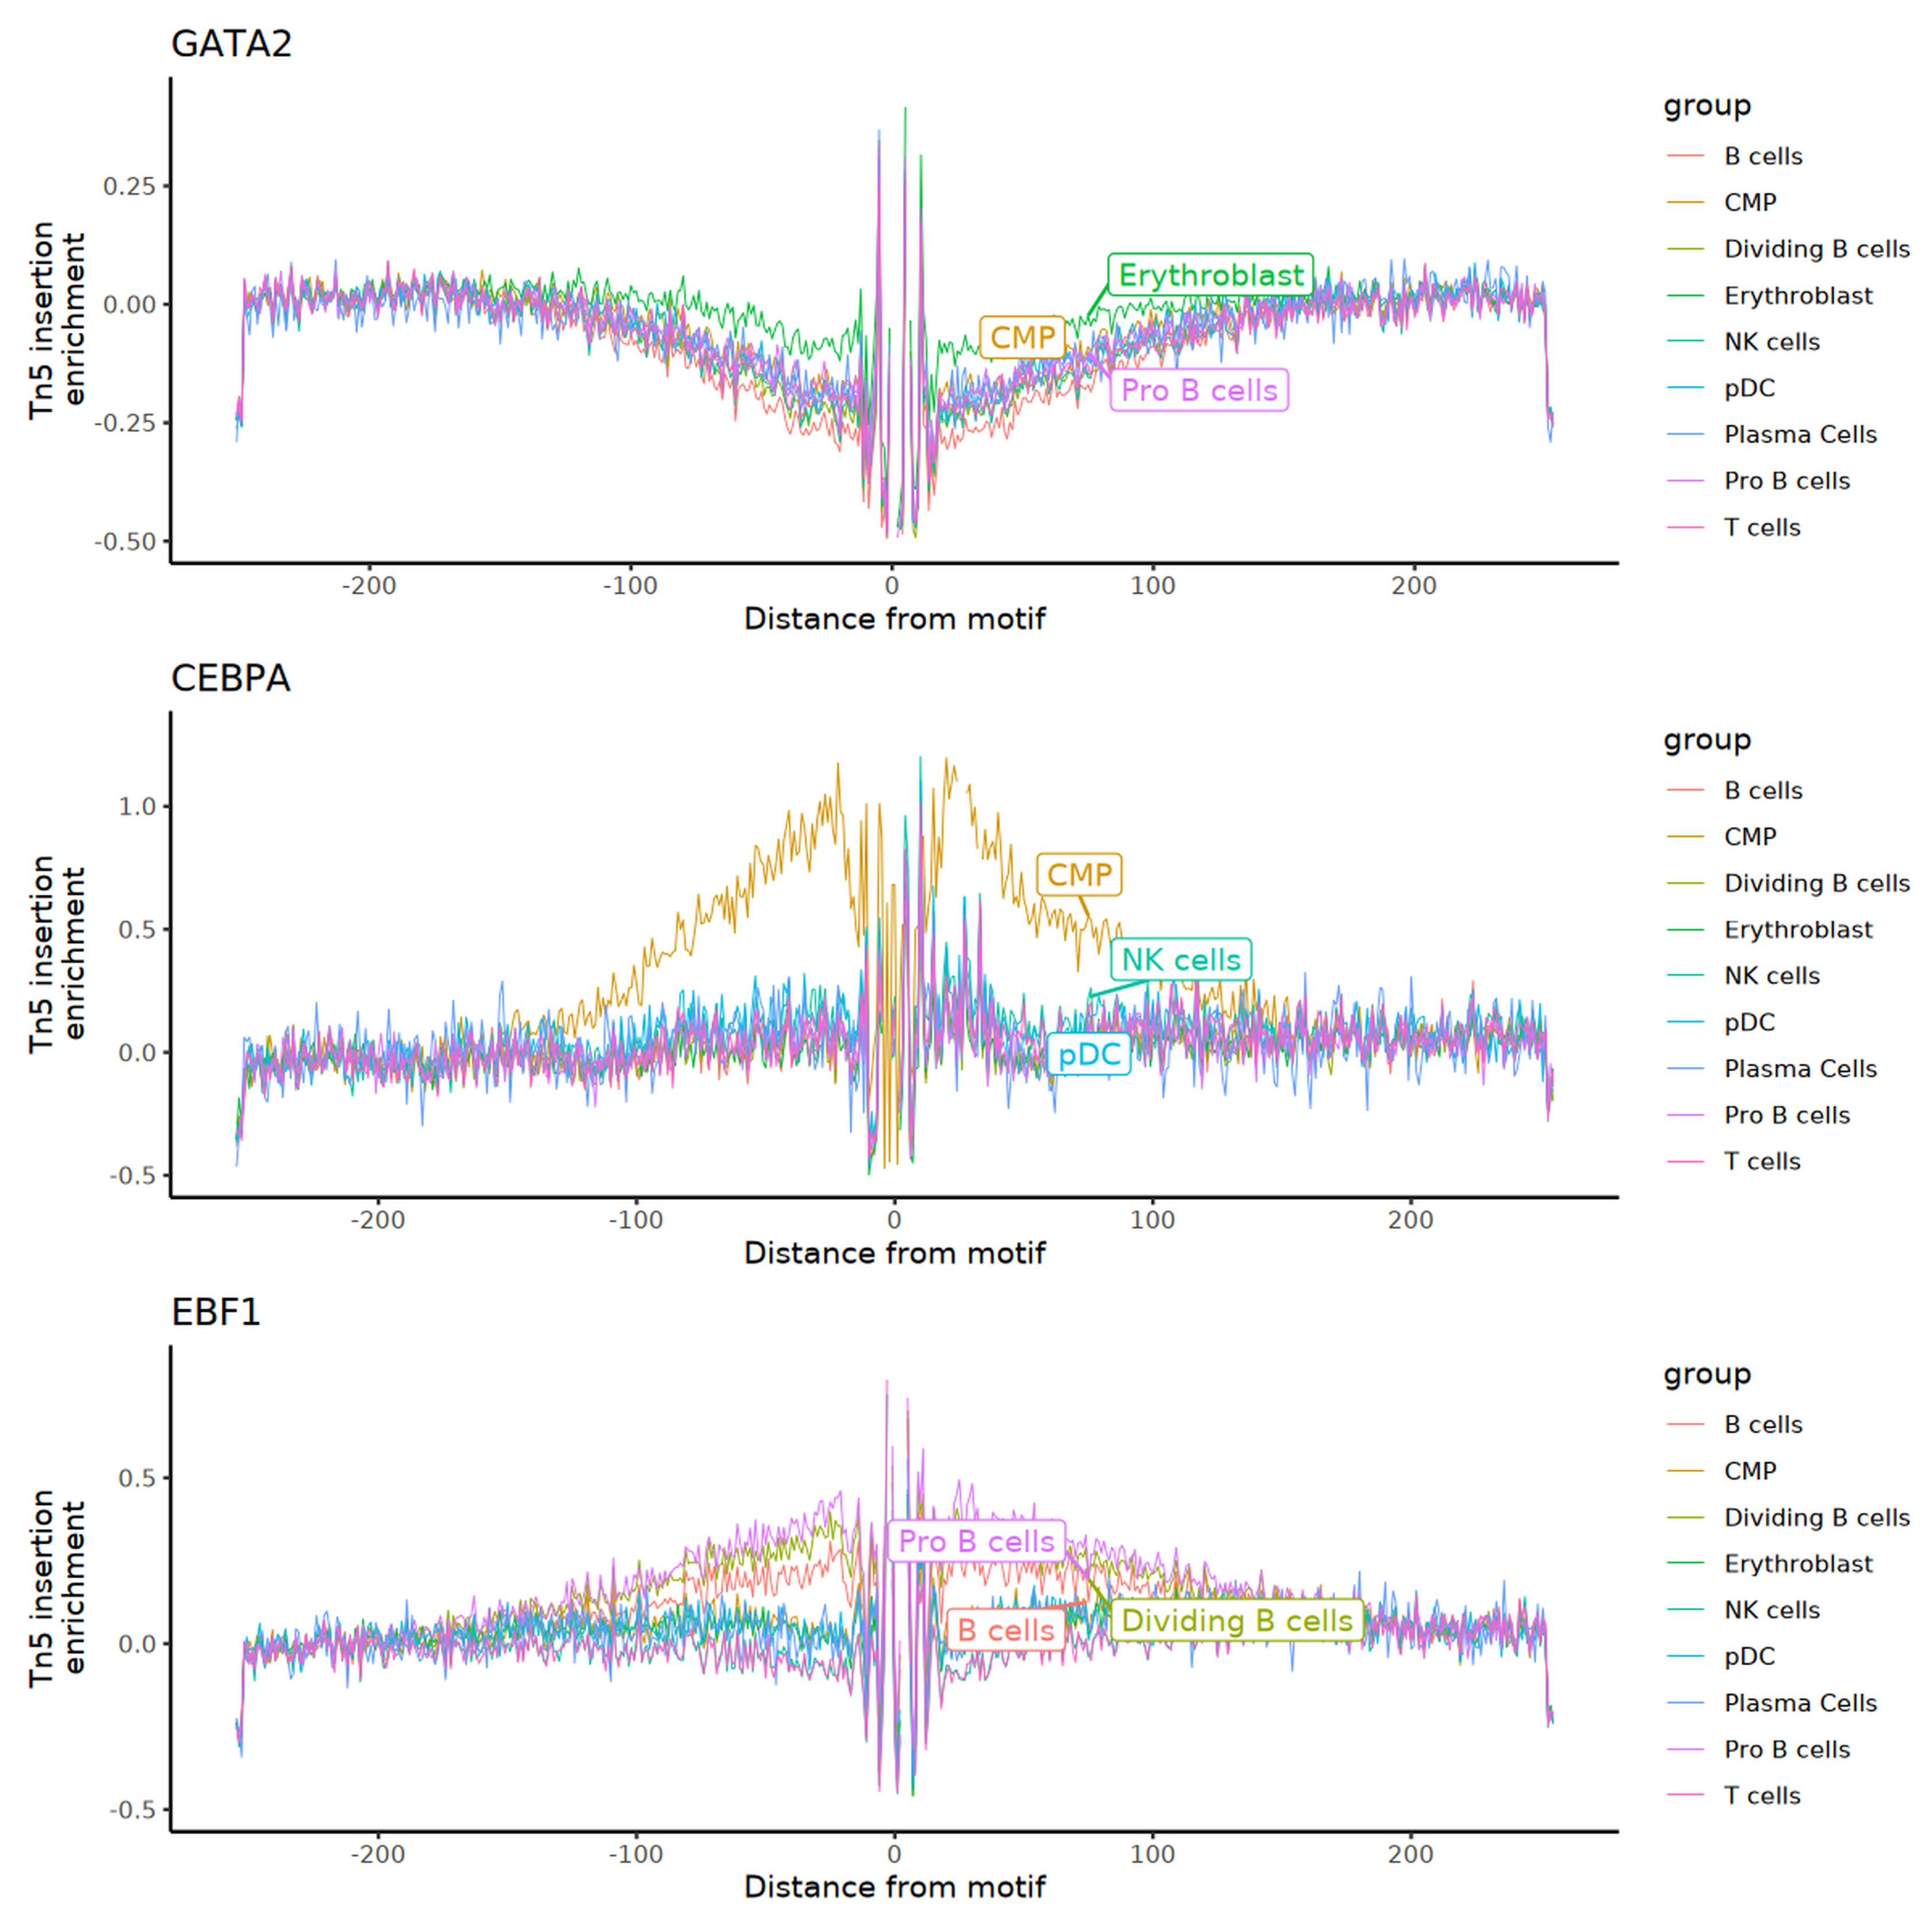
完成三元组分析后,已获得所有潜在的三元调控关系,但仍可能存在假阳性。转录因子足迹(Footprint)分析通过检测 ATAC-seq 片段在 TF 结合位点处的"保护效应"(即 TF 结合后该位点不易被 Tn5 转座酶切割),直接在碱基分辨率上评估 TF 的实际结合活性,是 Motif 活性分析的重要补充。
Footprint 分析的核心原理基于 Tn5 转座酶的切割机制:当转录因子蛋白结合在 DNA 上时,会物理性地阻挡 Tn5 酶对该区域的切割,从而在 Motif 结合位点中心形成一个信号相对较低的保护区(即"足迹"),而两侧则出现信号高峰。通过精确统计 Motif 位置上下游各 250bp 范围内的 Tn5 切割事件分布频率,并与背景期望模型(校正 Tn5 序列切割偏好性)进行比较,可定量评估 TF 的实际结合强度。值得注意的是,Motif 富集分析仅表明某序列在差异 Peak 中出现的频率高于背景,但无法证明 TF 是否真实结合;而 Footprint 分析通过检测物理保护效应,能够直接验证 TF 在目标位点的实际占据状态,从而实现从"可能结合"到"正在作用"的证据升级。
分析流程支持多种可视化模式:跨细胞类型的 Footprint 比较可揭示 TF 结合活性的细胞特异性;跨实验组的 Footprint 对比可验证疾病或处理条件下 TF 结合活性的动态变化;聚合 Footprint 图谱则通过整合多个 Motif 位点的信号,提升检测灵敏度。通过整合 Footprint 证据,可进一步过滤三元组分析中的假阳性结果,构建更可靠的转录调控网络。
7.1 相关教程
- 转录因子足迹分析:ATAC + RNA 多组学:转录因子足迹分析(Footprint)
分析内容:涵盖 Motif 位置定位与片段切割统计、Footprint 评分计算、细胞类型间比较及聚合 Footprint 可视化。
7.2 输入文件
Fragment 文件(fragments.tsv.gz)、Seurat 对象(含细胞类型注释)、参考基因组 FASTA 文件、Motif 位置频率矩阵
7.3 输出文件
TF Footprint 得分矩阵、聚合 Footprint 可视化图、细胞类型间 Footprint 差异比较图
8. DORC 拓展分析
前述三元组分析与 Footprint 分析均从转录因子(TF)视角出发,逐步验证"哪些 TF 通过哪些 Peak 调控哪些基因"。然而,从靶基因视角审视调控网络同样至关重要:并非所有基因都受到同等密度的调控,某些关键基因可能同时被多个增强子协同驱动,形成密集的顺式调控网络。DORC(Domains of Regulatory Chromatin, 主要调控元件)分析正是从这一视角出发,旨在识别与特定细胞类型或状态显著关联的多增强子协同调控靶基因,将表观遗传开放性与基因表达变化直接关联。此分析建立在 Peak2Gene 关联结果的基础之上,是调控元件识别向靶基因锁定的重要延伸。
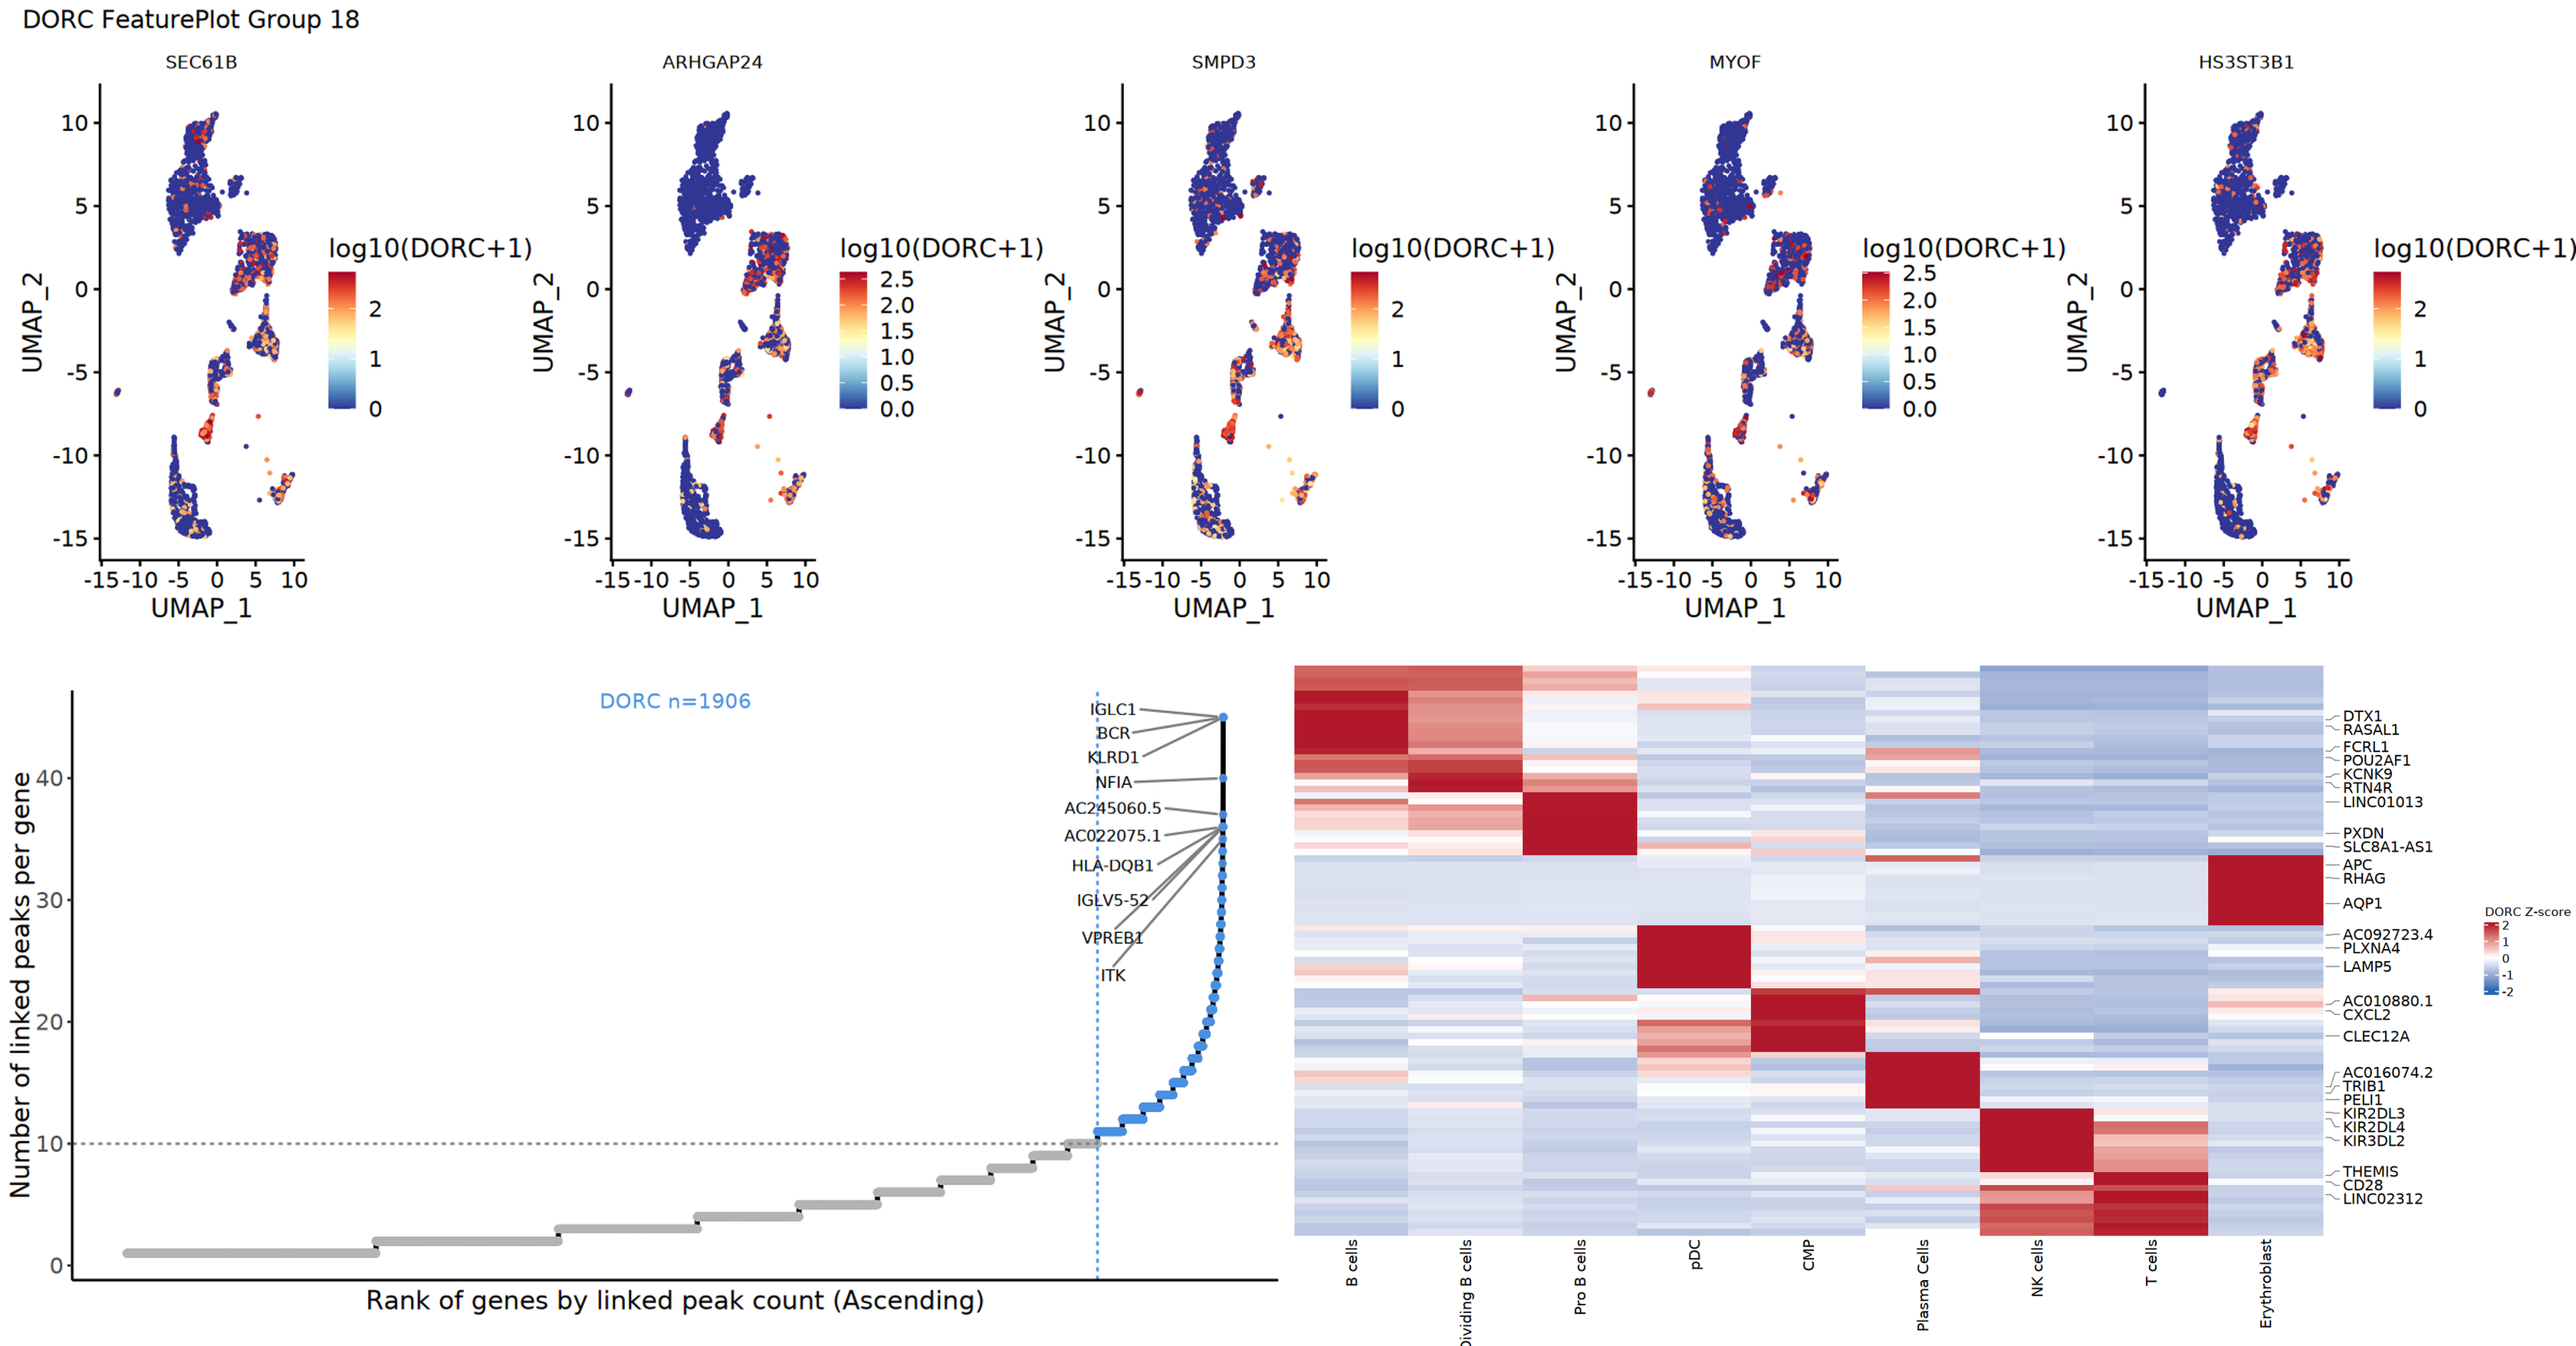
DORC 概念突破了单个增强子调控的局限,聚焦于那些受大量顺式调控元件协同控制的"超级靶基因"。其核心假设是:决定细胞命运、维持细胞状态或驱动疾病进展的关键调控枢纽,往往不是由单一增强子独立调控,而是由多个(通常 ≥10 个)分布在不同位置的增强子共同驱动。因此,DORC 分析首先在 Peak-to-Gene 关联结果的基础上,统计每个靶基因在全基因组范围内关联的显著 Peak 总数;随后,设定严格的背景阈值(默认 ≥10 个 Peak),将关联元件数量显著超越该阈值的基因鉴定为 DORC 基因。这些 DORC 基因代表了受密集顺式调控网络控制的转录枢纽,是细胞身份建立与维持的核心驱动因子。
在鉴定 DORC 基因后,分析进一步计算每个细胞中靶向同一 DORC 基因的所有 Peak 的累积可及性,生成单细胞水平的 DORC 活性评分(Accessibility Score)矩阵。通过整合多个 Peak 的信号,DORC 评分能够有效克服单个增强子信号稀疏的问题,更稳健地反映该基因上游的整体调控强度。基于 DORC 活性矩阵的差异分析与聚类热图可视化,可揭示维持特定细胞群稳态或驱动其分化的标志性调控枢纽,为功能验证实验提供高优先级候选靶点。
8.1 相关教程
- DORC 基因识别与分析:ATAC + RNA 多组学:DORC 分析
分析内容:涵盖 Peak-Gene 关联导入与 DORC 基因筛选、细胞类型特异性评估、GO/KEGG 功能注释及 DORC 热图可视化。
8.2 输入文件
Seurat 对象(含 RNA + ATAC 双模态数据与细胞类型注释)、Peak2Gene Links 文件、差异 Peak 分析结果
8.3 输出文件
DORC 基因列表(含关联 Peak 数、表达特异性得分)、DORC 基因功能富集结果、可视化图件
9. SCENIC+ 调控网络分析
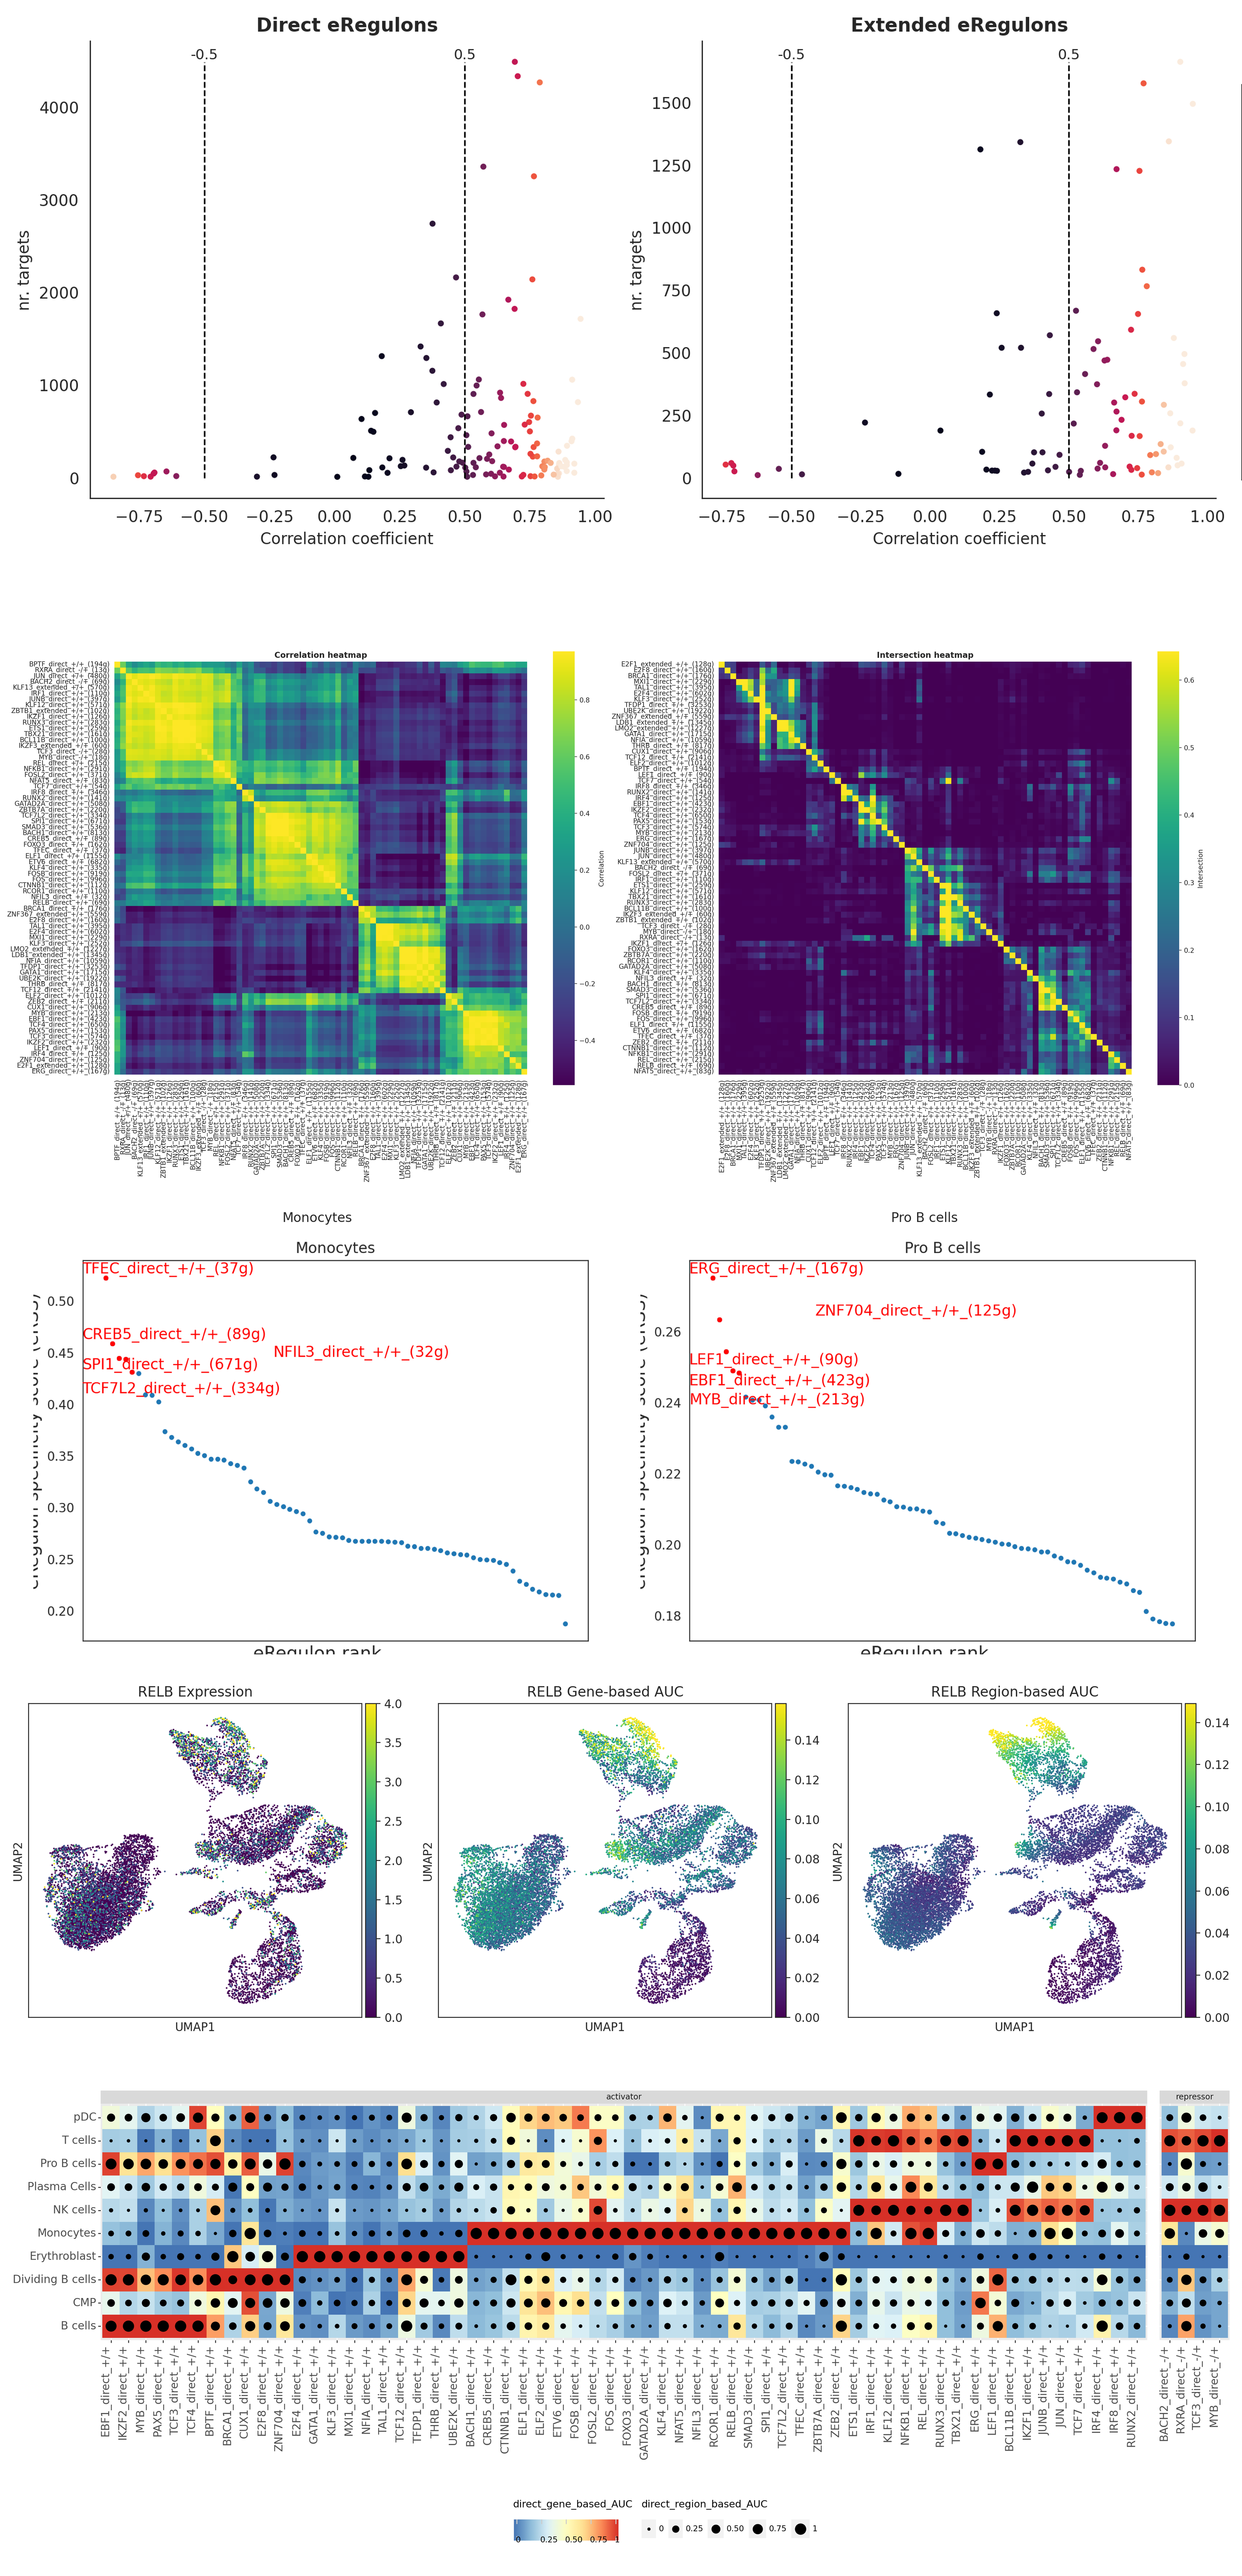
前述第 3-8 章构成了一条自下而上的逐步解析路径:从差异 Peak 识别到 Motif 富集,从 Peak-Gene 关联到三元组组装,从 Footprint 验证到 DORC 锁定,各模块独立而互补,适合针对特定生物学问题进行定向深入。然而,若研究目标是在全基因组尺度系统性解析完整的转录调控网络,则需要采用自上而下的整合策略。SCENIC+(Single-Cell Regulatory Network Inference and Clustering Plus)正是此类金标准工具,它通过整合 scRNA-seq 的基因表达信息与 scATAC-seq 的染色质可及性信息,在统一框架内一次性完成从 TF 到调控元件到靶基因的全局推断,并利用染色质开放性约束显著降低假阳性,构建"TF → 调控元件(eRegulon)→ 靶基因"的完整调控网络。
SCENIC+ 相较于传统 SCENIC 方法的核心优势在于:传统 SCENIC 仅基于基因表达共变性推断 TF-靶基因关系,容易产生大量间接调控的假阳性连接;而 SCENIC+ 通过整合染色质可及性数据,要求推断的调控关系必须在 ATAC 数据中得到支持——即 TF 的 Motif 必须存在于靶基因附近的可及性区域中,这种多组学约束显著提升了调控网络的特异性。分析流程的核心概念是eRegulon(enhanced Regulon),它定义了"TF + 一组受其调控的靶基因 + 调控这些基因的顺式调控元件"的完整功能单元。eRegulon 分为两类:direct eRegulon 基于 TF 直接结合染色质区域的证据,假阳性率最低;extended eRegulon 通过基因距离或染色质互作等间接信息推断,覆盖范围更广。
分析流程包含四个关键步骤:首先通过 pycisTopic 主题建模识别共变的可及性区域(Topic Modeling);随后构建 cisTarget 数据库进行 Motif 富集分析;接着执行 SCENIC+ 核心推断,整合 RNA 与 ATAC 数据构建 eRegulon;最后通过后处理步骤(包括 TF 表达-AUC 相关性评估、Gene/Region AUC 一致性检验、Regulon 特异性评分 RSS 等)筛选高质量 eRegulon。RSS 评分可量化每个 eRegulon 在不同细胞类型中的特异性富集程度,是识别细胞类型特异性调控因子的关键指标。
9.1 相关教程
- SCENIC+ 多组学调控网络推断与后处理:ATAC + RNA 多组学:SCENIC+ 多组学调控网络分析
分析内容:涵盖 Seurat→AnnData 转换、pycisTopic 主题建模、cisTarget 数据库构建、SCENIC+ 调控网络推断(eRegulon 构建)及后处理可视化(RSS 评分、UMAP 降维、调控网络图)。
9.2 输入文件
Seurat 对象(含 RNA + ATAC assay,*.rds)、元数据文件(可选,meta.tsv)、ENCODE 黑名单文件、参考基因组 FASTA 与染色体大小文件、Aertslab Motif collection 文件(*.cb)、Mallet 与 Cluster Buster 可执行文件
9.3 输出文件
scplusmdata.h5mu(MuData 对象含 eRegulon AUC 矩阵)、ctx_results.hdf5(cisTarget Motif 富集)、dem_results.hdf5(差异可及性分析)、AUCell_direct/extended.h5mu(AUCell 活性矩阵)、eRegulon 质量评估报告与 RSS 评分
10. 基于 ATAC 的 Monocle3 轨迹分析
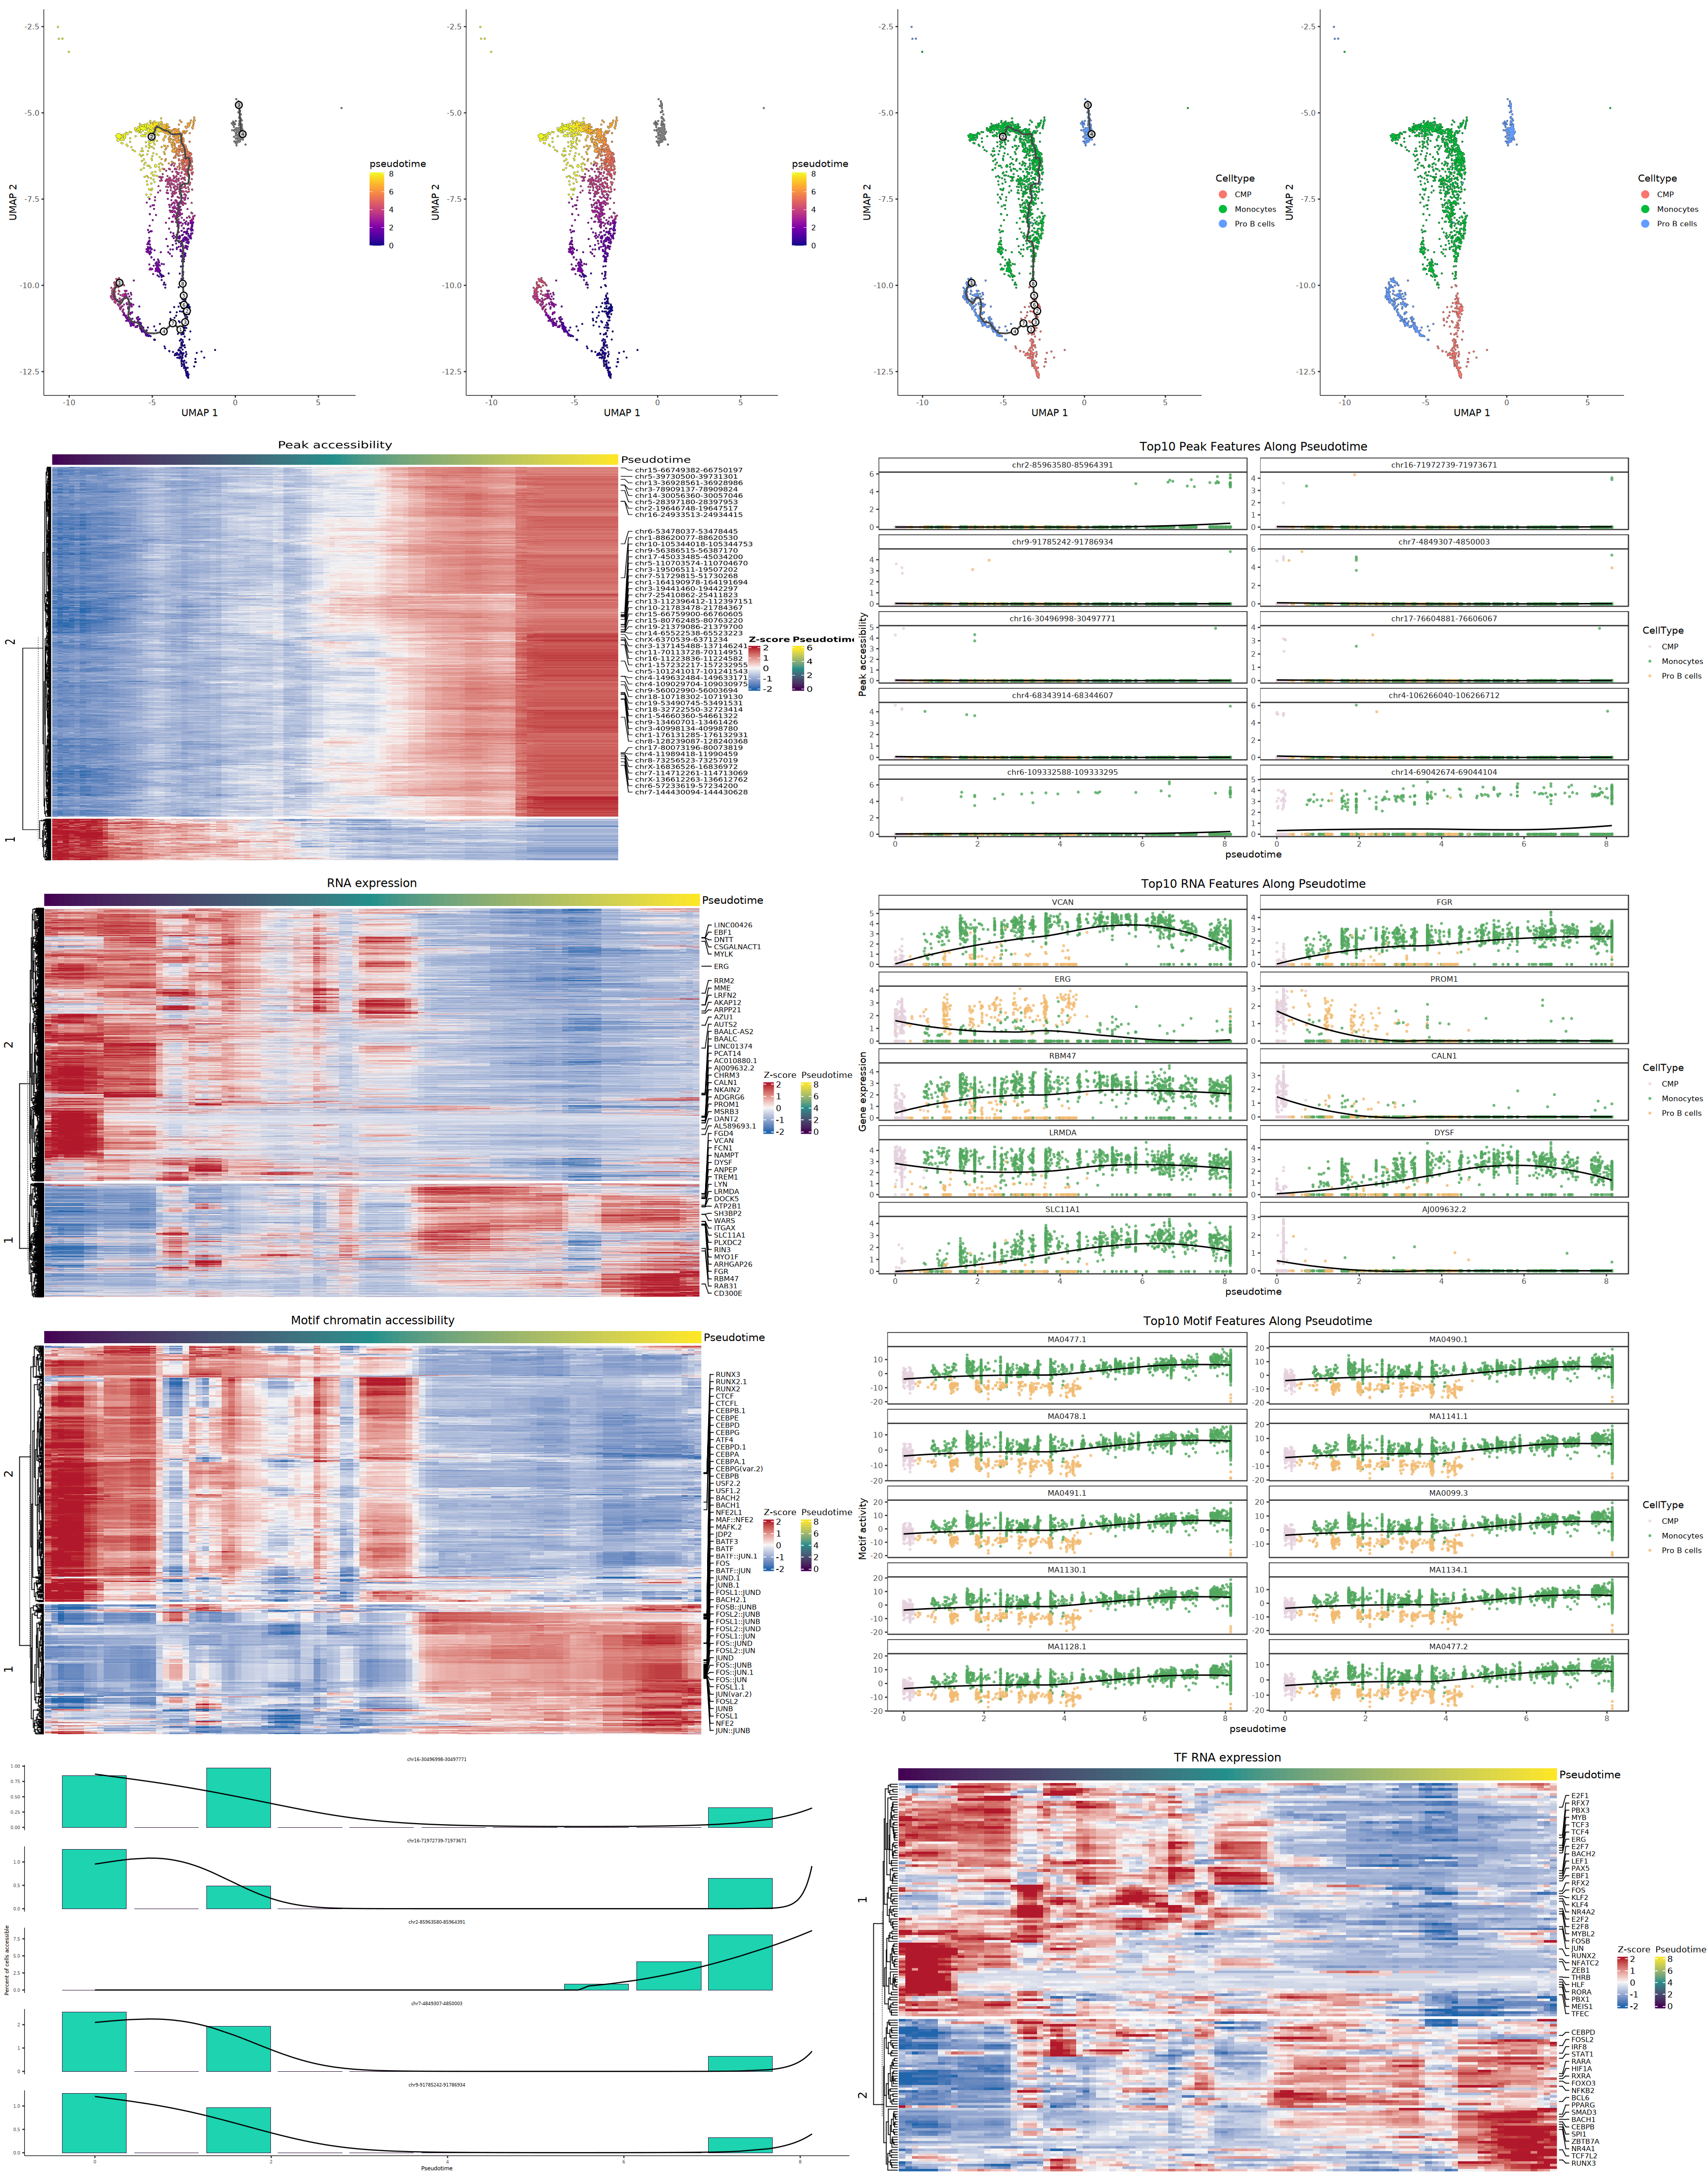
前述第 3-9 章聚焦于不同细胞类型或实验条件下的静态调控网络解析,揭示的是"在特定状态下谁在调控谁"。然而,许多生物学过程(如发育分化、疾病进展)本质上是连续的动态过程,仅凭静态快照难以捕捉调控事件的时序逻辑。Monocle3 轨迹分析是一条可与前述调控网络分析并行或互补的可选分析轨道,在完成基础细胞类型注释后即可启动,不依赖后续高级分析的结果。它利用 Monocle3 轨迹推断算法重建细胞从"起点"到"终点"的连续发育或分化过程,通过拟时序(Pseudotime)分析将高维空间中离散的细胞沿隐含的生物学进程轨迹排序,从而揭示 Peak 可及性、Motif 活性与基因表达沿发育轨迹的动态变化规律。
本教程围绕三个核心模态展开,系统性地重建"调控发起 → 染色质变化 → 基因表达"的完整逻辑链条:
- Peak(染色质开放峰):代表顺式调控元件,其开放程度随拟时序发生动态变化。
- Motif(转录因子结合基序):反映 TF 在染色质层面的潜在结合活性随拟时序的动态变化。
- Gene(基因表达):调控事件在转录层面的最终功能输出,沿拟时序呈现时空特异性的表达模式。
Monocle3 的核心算法是主图学习(Principal Graph Learning):在降维空间(UMAP)中,算法通过学习连接各细胞状态群的最优图结构,构建出能够捕获细胞状态连续转变的轨迹骨架。以用户指定的根细胞群(如干细胞、祖细胞)为起点,沿主图计算每个细胞的拟时序值,从而实现细胞沿发育进程的排序。分析流程支持多模态联合分析:首先基于 ATAC 数据学习轨迹拓扑结构,随后通过模态切换(Assay Swap)将同一轨迹框架应用于 RNA 表达矩阵与 ChromVAR Motif 活性矩阵,分别检测沿拟时序显著变化的 Peak、Motif 和 Gene。这种"一套轨迹框架、多种模态分析"的策略,使得研究者能够在统一的发育时间轴上,精确解析转录因子表达变化、染色质可及性重塑与靶基因转录激活之间的时序关系与因果逻辑。
10.1 相关教程
- 基于 ATAC 的 Monocle3 轨迹分析:ATAC + RNA 多组学:基于 ATAC 的 Monocle3 分析
分析内容:涵盖 Monocle3 轨迹推断与拟时序计算、沿拟时序的差异 Peak/Motif/基因检测及多模态联合可视化(热图与散点图)。
10.2 输入文件
Seurat 对象(.rds,需包含 ATAC/RNA Assay、聚类信息及 UMAP 降维结果)、参考基因组 FASTA 文件、细胞元数据文件(可选,meta.tsv)
10.3 输出文件
CDS 对象(cds.rds,含拟时序值)、拟时序轨迹可视化图、差异 Peak/Motif/Gene 统计表(CSV)、多模态平滑热图、Top 特征沿拟时序散点图
11. 数据分析建议
提示:ATAC-RNA 双组学分析是一项高度依赖生物学问题驱动的系统性工作。本指南提供的多维度分析模块旨在构建从表观调控到转录输出的完整机制解析链路,您可以根据数据质量、细胞类型复杂度及核心研究目标,灵活组合分析路径。
11.1 核心分析路径建议
ATAC-RNA 双组学分析的核心逻辑是层层递进、多维验证:从基础细胞图谱构建,到调控元件识别,再到完整调控网络解析。根据研究目标的不同,建议遵循以下分析路径:
基础解析与图谱构建:依次完成 "基础分析"(单样本质控聚类 或 多样本整合批次校正),实现细胞无监督分群与细胞类型注释。这是所有下游分析的数据基础,其质量直接决定后续分析的可靠性。对于单样本数据,Signac 路线的 WNN 多模态聚类通常能发现更精细的细胞亚群;对于多样本数据,需根据批次效应强度选择 Harmony(快速稳健)或 CCA(适合批次效应较强)进行整合。
差异特征与调控线索挖掘:在获得细胞注释后,依次进行 "差异可及性分析"(识别细胞类型特异性 Peak 或条件特异性差异 Peak)与 "Motif 分析"(通过 ChromVAR 评估 TF 活性、通过富集分析识别调控 TF),建立"调控元件—转录因子"的初步关联。若研究关注细胞的连续发育或分化过程,可同时执行 "Monocle3 轨迹分析",揭示 Peak、Motif 和基因表达沿拟时序的动态变化规律,解析调控事件的时序逻辑。
调控机制深度解析:基于差异 Peak 与 Motif 线索,执行 "Peak2Gene 关联分析" 建立调控元件与靶基因的物理连接,再通过 "TF-Peak-Gene 三元组分析" 整合多维证据(TF-Peak 结合、Peak-Gene 相关性、TF 活性一致性)筛选高置信度调控关系,并通过 "TF Footprint 分析" 在碱基分辨率验证 TF 的实际结合活性,最终通过 "DORC 分析" 锁定受多个增强子协同驱动的关键调控基因。
完整调控网络构建:若目标是系统性解析全基因组尺度的调控网络,推荐直接使用 "SCENIC+ 分析" 完成从 TF 到 eRegulon 到靶基因的完整推断。SCENIC+ 通过染色质可及性约束显著降低假阳性,是构建调控网络的金标准。结合 RSS 评分可识别细胞类型特异性调控因子,为功能验证提供高优先级候选靶点。
11.2 分析模块的递进与衔接
基础分析(细胞注释)
    ↓ 驱动
差异可及性分析(差异 Peak)──→ Motif 分析(富集 TF)
    ↓                              ↓
    └──────── Peak2Gene 关联 ──────┘
                     ↓
              TF-Peak-Gene 三元组
                     ↓
              TF Footprint 验证
                     ↓
              DORC 基因锁定
                     ↓
         SCENIC+ 完整调控网络(可选,系统性全景)

Monocle3 轨迹分析(可选,揭示 Peak/Motif/Gene 沿拟时序的动态变化)
11.3 工具选择指南
选择合适的分析工具是确保分析效率与结果可靠性的关键。以下工具选择指南基于各工具的核心优势与适用场景,帮助您根据具体需求做出决策:
| 分析需求 | 推荐工具 | 关键考量 |
|---|---|---|
| 快速完成全链路基础分析 | ArchR | 内存效率高,内置功能完整,适合处理大规模数据集(>10 万细胞)。采用 LSI 迭代降维,可快速完成从质控到聚类的完整流程。 |
| 需要与 Seurat 生态整合 | Signac | 可视化丰富,第三方工具兼容性好。支持 WNN 多模态联合聚类,能够动态评估 RNA 与 ATAC 两种模态对细胞相似性的相对贡献。 |
| 多样本批次校正 | Signac + Harmony/CCA | 灵活选择校正算法。Harmony 计算效率高、适合多样本快速整合;CCA 基于锚点整合策略,适合批次效应较强的场景。需根据 UMAP 可视化评估矫正效果。 |
| 差异 Peak 与功能富集 | DifferentialAccessibility | 支持 Cluster vs All(细胞类型特异性)与 Case vs Control(条件特异性)两种模式,基于 presto::wilcoxauc 进行高效统计检验,直接整合 ClosestFeature 邻近基因注释与 GO/KEGG 富集分析。 |
| TF 结合模式推断 | Motif Analysis + Footprint | Motif 打分揭示潜在结合模式,Footprint 分析通过 Tn5 酶切保护效应在碱基分辨率验证实际结合活性。两者结合实现从"可能结合"到"正在作用"的证据升级。 |
| 调控元件-靶基因映射 | Peak2Gene + TF Trios | Peak2Gene 基于共变性假设建立物理连接,TF Trios 整合 TF-Peak 结合、Peak-Gene 相关性、TF 活性一致性三重证据,通过 Linkage Score 量化多点联合调控强度。 |
| 细胞发育/分化轨迹推断 | Monocle3 | 基于主图学习算法重建连续发育轨迹,支持多模态联合分析。可在统一的拟时序框架下解析 Peak 开放性、Motif 活性与基因表达的动态变化。 |
| 全基因组调控网络 | SCENIC+ | 金标准工具,通过染色质可及性约束显著降低假阳性。构建 eRegulon(TF + 靶基因 + 顺式调控元件)完整调控单元,但计算资源需求高,需要构建自定义 cisTarget 数据库。 |
| 细胞类型特异性调控因子 | DORC + SCENIC+ RSS | 互补验证策略。DORC 识别受多个增强子协同驱动的超级靶基因;SCENIC+ RSS 评分量化 eRegulon 在不同细胞类型中的特异性富集程度。两者结合可锁定高优先级候选靶点。 |