算法原理
数据结构
SeekOne DD Single Cell Multiome Methylation + RNA 文库提供两种化学方法。
- DD-MET3(双标签):同一细胞的 RNA 和 DNA 甲基化数据 barcode 不同,RNA 文库为 3' 端转录组文库。
- DD-MET5(单标签):同一细胞的 RNA 和 DNA 甲基化数据 barcode 相同,RNA 文库为 5' 端转录组文库。
DD-MET3 甲基化文库结构
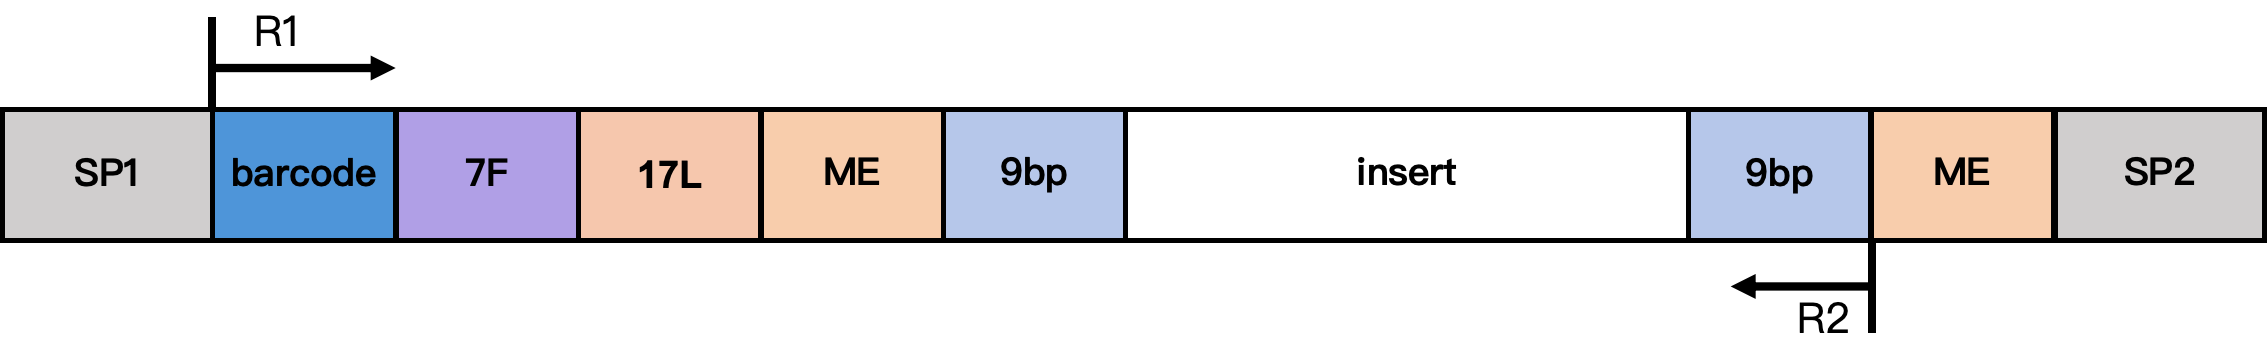
结构说明:
- SP1/SP2:接头序列
- barcode:17 bp 细胞 barcode
- 7F:7 bp 连接序列
- 17L:17 bp 固定序列
CgtCCgtCgttgCtCgt - ME:19 bp 固定序列
AGATGTGTATAAGAGACAG - 9 bp:Tn5 插入片段的延伸序列
DD-MET5 甲基化文库结构
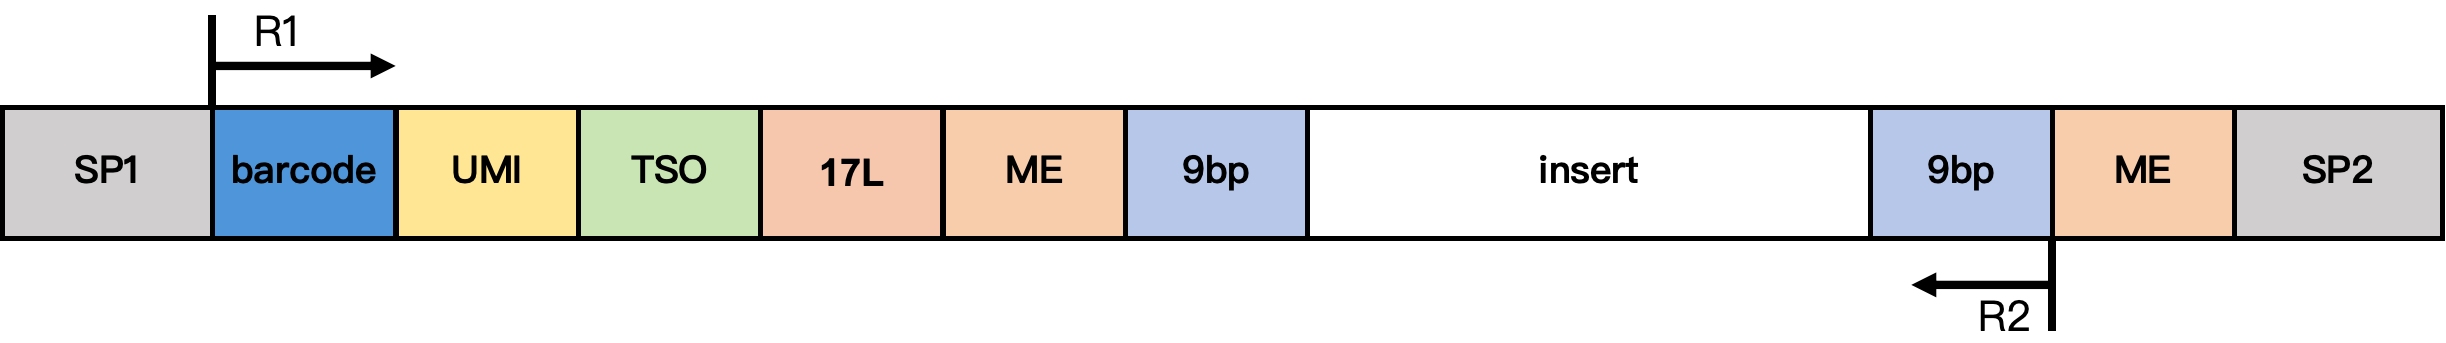
结构说明:
- SP1/SP2:接头序列
- barcode:17 bp 细胞 barcode
- UMI:12 bp UMI 序列
- TSO:13 bp TSO 序列
TTTCTTATATGGG - 17L:17 bp 固定序列
CgtCCgtCgttgCtCgt - ME:19 bp 固定序列
AGATGTGTATAAGAGACAG - 9 bp:Tn5 插入片段的延伸序列
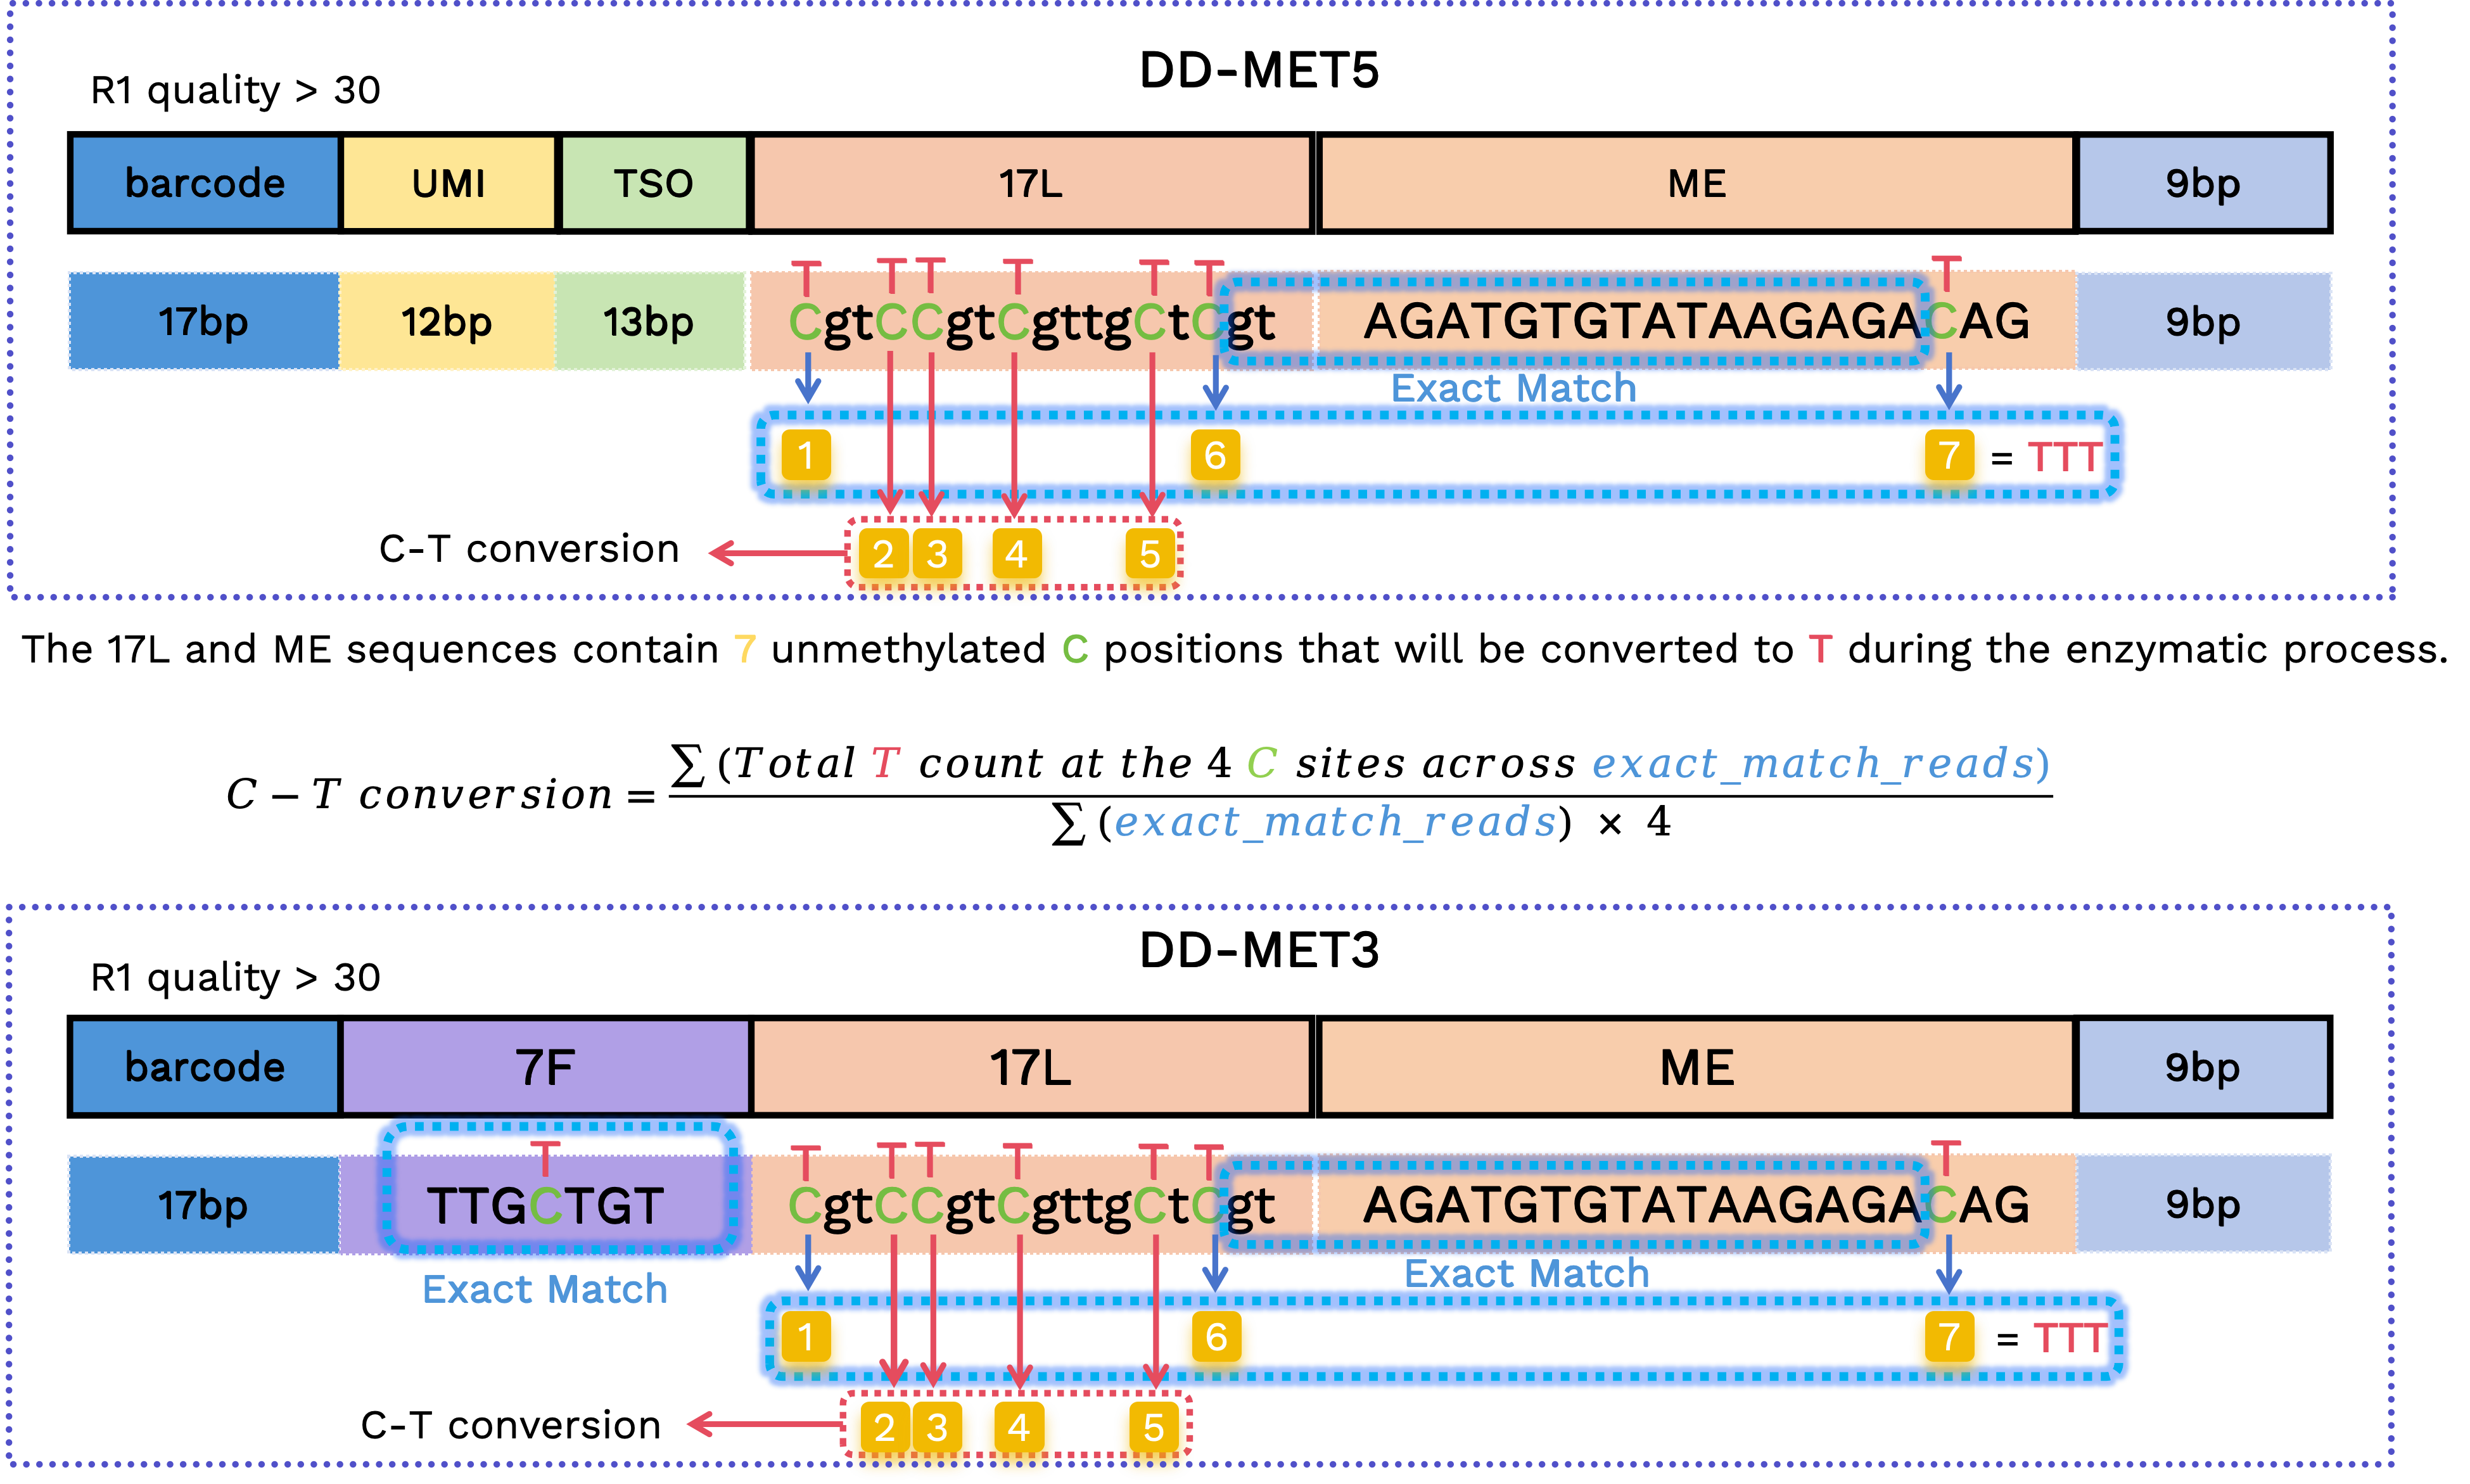
在酶转化过程中,未甲基化的胞嘧啶被转化为胸腺嘧啶。SP1 和 SP2 中的胞嘧啶经过甲基化修饰而受到保护,防止在转化过程中引入测序接头错误;甲基化数据所用的 barcode 不包含任何 C 碱基。相比之下,7F、17L 和 ME 中的固定序列胞嘧啶则故意不加保护,在酶转化过程中被转换为 T,稍后用于估计 C 到 T 的转化率。
转录组工作流
转录组处理通过 SeekSoulTools 执行。根据转录组派生的细胞 barcode 确定保留用于甲基化下游分析的细胞。
甲基化工作流
第 1 步:预处理和 Barcode 解析
Barcode 提取和校正
流程根据预期的文库结构定位 barcode 区域。如果提取的 barcode 出现在白名单中,则直接保留。否则,流程将尝试进行一个错配的 barcode 校正:
- 如果恰好找到一个白名单候选者,则将 barcode 校正为该候选者。
- 如果匹配到多个候选者,则选择 read 计数最高的 barcode。
- 如果未找到有效的校正,则将该 read 作为无效 barcode read 丢弃。
在 v2.2.0 中,barcode 校正使用基于前缀树(trie)的 Hamming 距离搜索实现,可高效支持距离大于 1 的校正。
UMI 提取
从预定义位置提取 UMI,在解析期间不对其进行校正。
正向和反向 read 确定
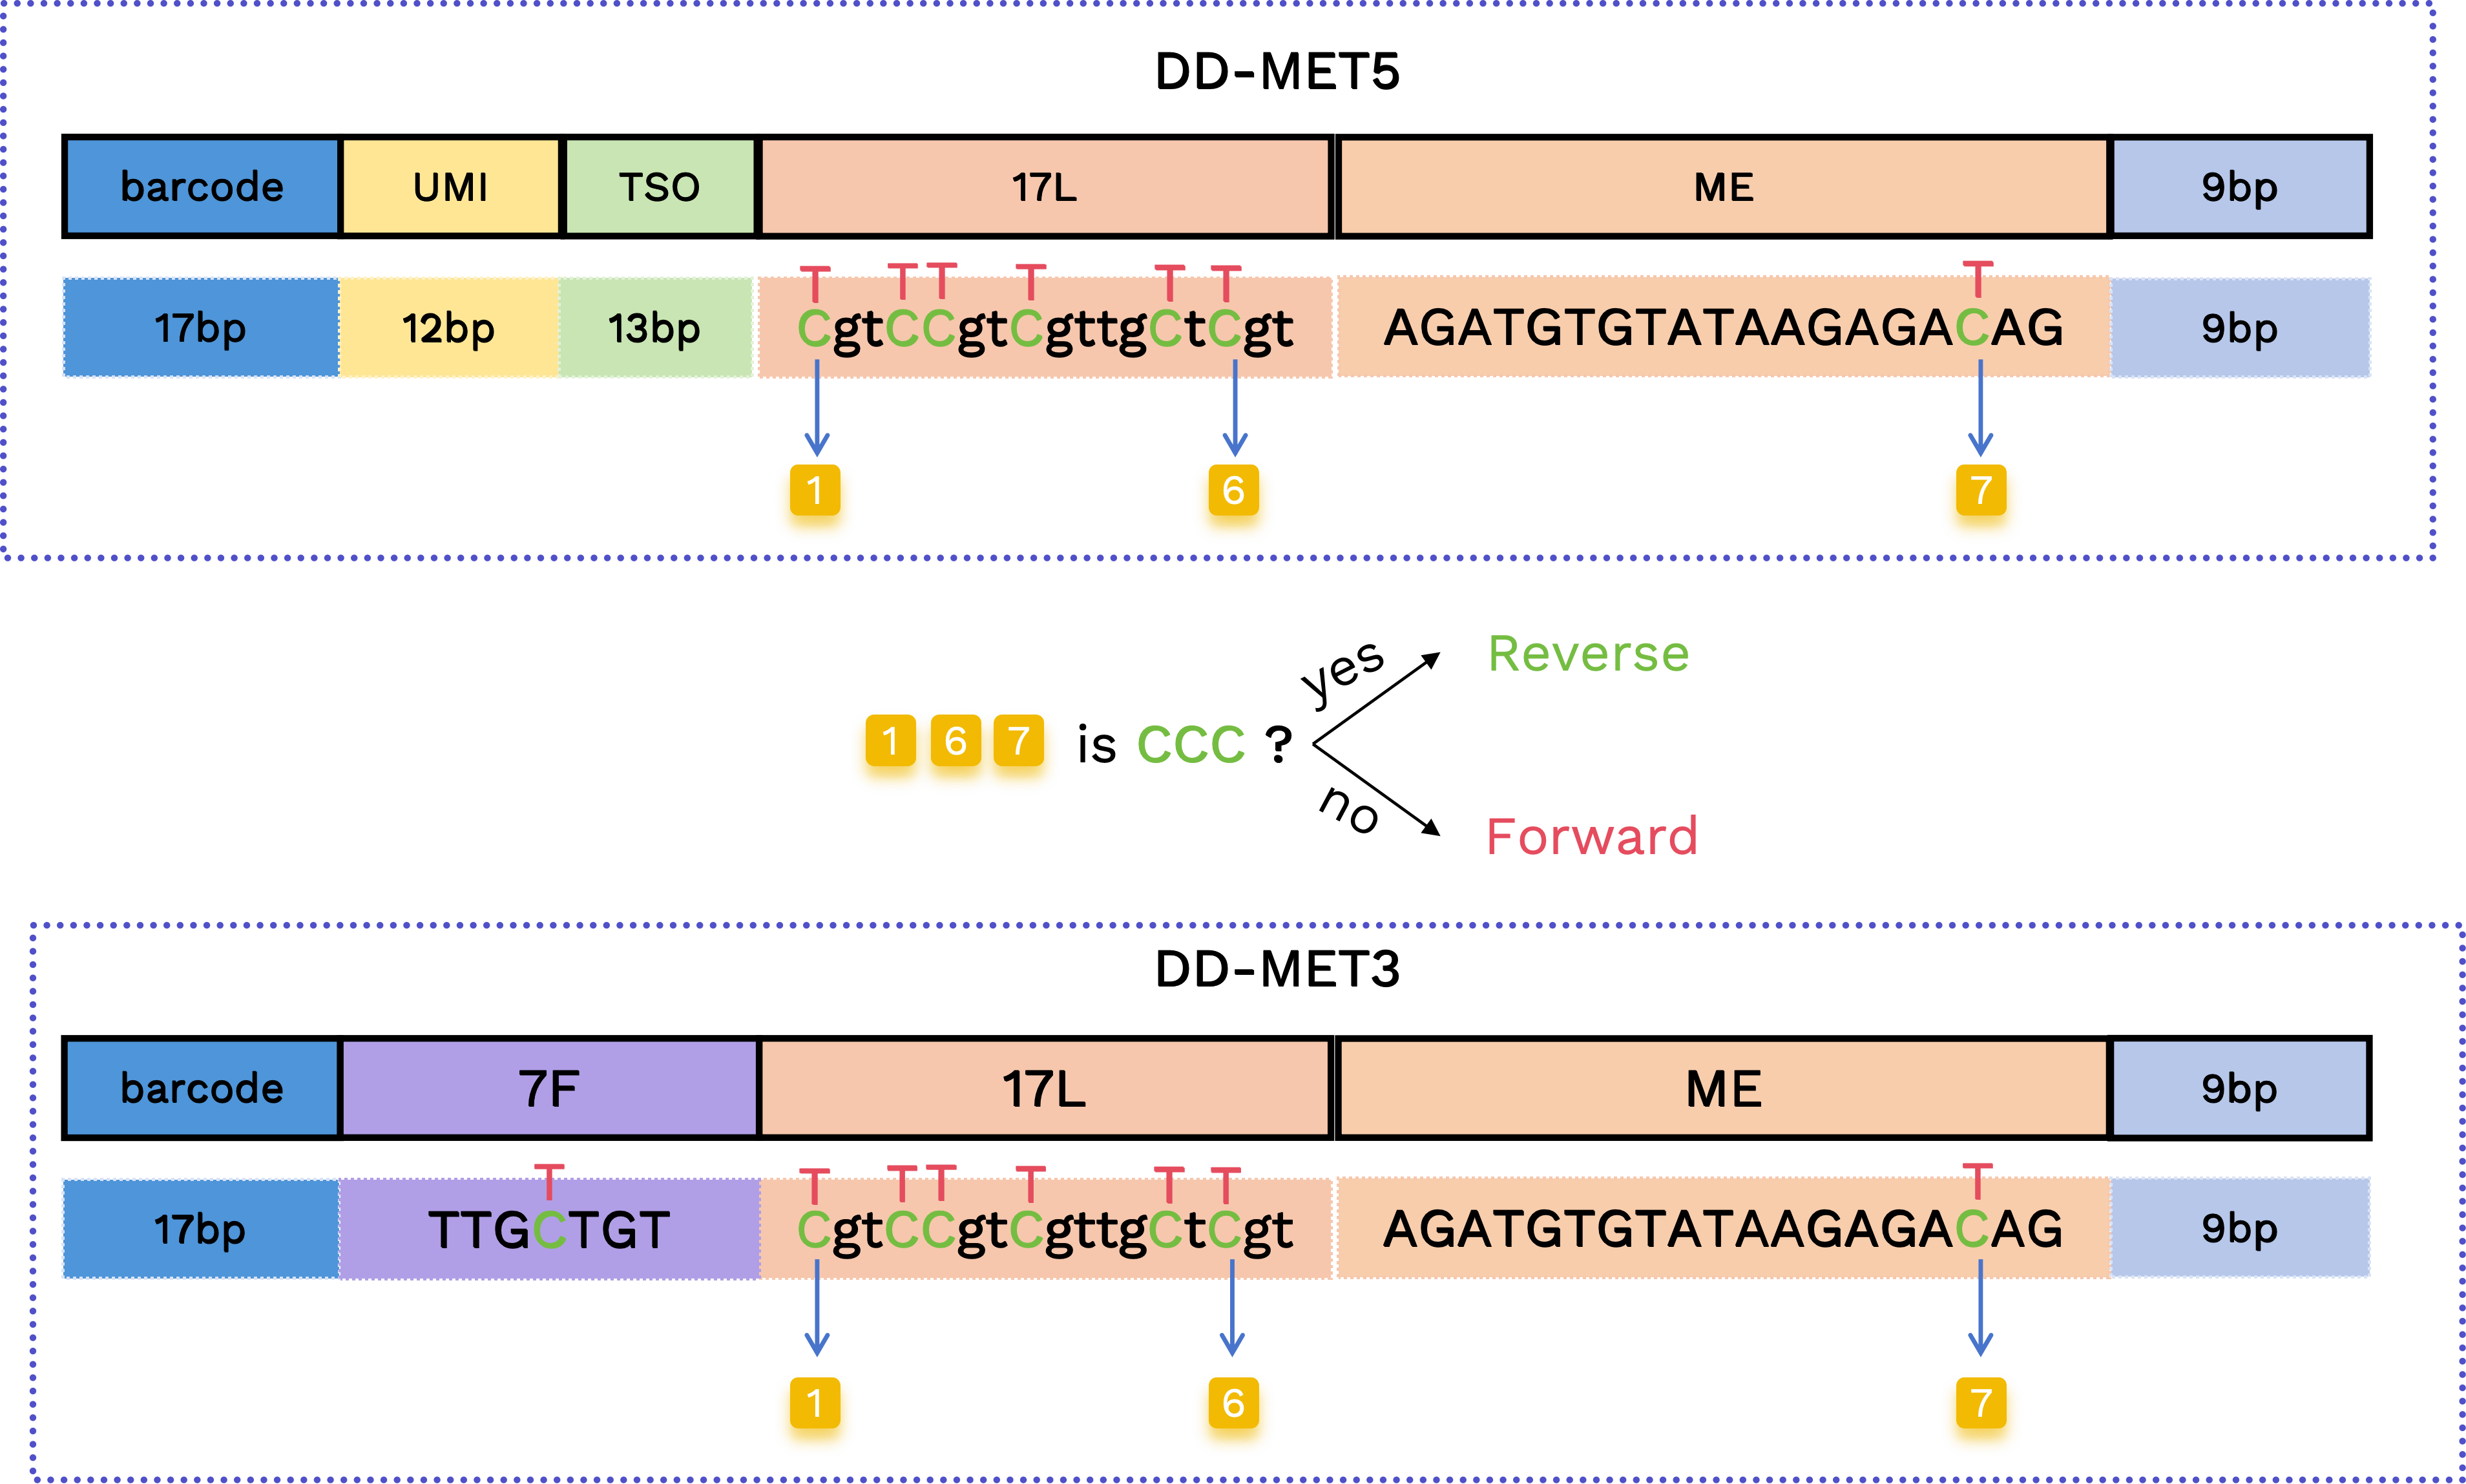
使用 17L 和 ME 片段中的前两个和最后一个原始胞嘧啶位置来区分正向和反向 read。如果这三个位置都保留为胞嘧啶,则将该 read 分类为反向;否则分类为正向。
- 正向 read 模式:
TgtTTgtTgttgTtTgtAGATGTGTATAAGAGAT - 反向 read 模式:
CgtCCgtCgttgCtCgtAGATGTGTATAAGAGAC
反向 read 对应甲基化术语中的 CTOT/CTOB(原始链的反向互补链);正向 read 对应 OT/OB(原始链)。
C 到 T 转化率
为了估计转化效率,工作流检查 17L 和 ME 片段中的固定序列胞嘧啶位点,但仅针对结构经验证的 read。具体而言:
- 在 DD-MET3 中,7F 序列必须为
TTGCTGT或TTGTTGT,17L 和 ME 跨区域的序列必须为GTAGATGTGTATAAGAGA,且第一个和最后两个原始 C 位置的碱基必须为 T。 - 在 DD-MET5 中,17L 和 ME 跨区域的序列必须为
GTAGATGTGTATAAGAGA,且第一个和最后两个原始 C 位置的碱基必须为 T。
对于保留的 read,工作流提取相应位置的碱基来计算 C 到 T 的转化率。此计算仅限于高置信度子集,并且不会从最终的 FASTQ 输出中删除 read。
Read 清理和过滤
随后,流程对 read 执行一系列清理和过滤步骤:
- 人工序列去除:根据文库设计中的预定义位置,从 Read1 中去除 TSO/7F 连接序列、17L 和 ME 序列。
- 接头修剪:使用 cutadapt 去除因 R1/R2 read-through 事件(双端测序 reads 重叠)引入的 ME 接头序列。
- 修剪 Tn5 转座酶引入的 9 bp 间隔:去除接头和其他人工序列后,额外修剪 Tn5 转座引入的插入片段两侧的 9 bp 间隔区域。这些 9 bp 区域可能携带人工甲基化信号,并在插入边界附近虚假地提高 CH 甲基化水平,因此在下游分析前予以去除。
- 过滤含有过多非 CpG 甲基化 C 碱基的 reads(可选):根据 read pair 中非 CpG 甲基化 C 碱基的数量进行过滤。默认情况下,read1/read2 中检测到超过 2 个非 CpG 甲基化 C 的 read pair 将被去除;如不需要启用此过滤,请将
filter_ch设置为 0。此过滤策略基于 Lu 等人 [1] 的研究发现,该研究表明合成接头中的切口(nick)可触发 Bst 聚合酶的切口平移活性,该活性会掺入 5-甲基-dCTP,导致完全未转换的 reads,表现为人工甲基化信号。 - 过滤过短 reads:经过前述过滤和接头修剪步骤后,如果 read pair 中 R1 的长度小于 20 bp 或 R2 的长度小于 60 bp,则该 read pair 将被过滤掉。
第 2 步:Bismark 比对和 BAM 排序
甲基化比对使用定制的 Bismark 构建。工作流将校正后的细胞 barcode 和原始 UMI 添加到 BAM 标签中,使用不同的选项比对正向和反向 read 组,并按 read 名称对 BAM 文件进行排序,以供下游处理。
第 3 步:ALLCools 分析
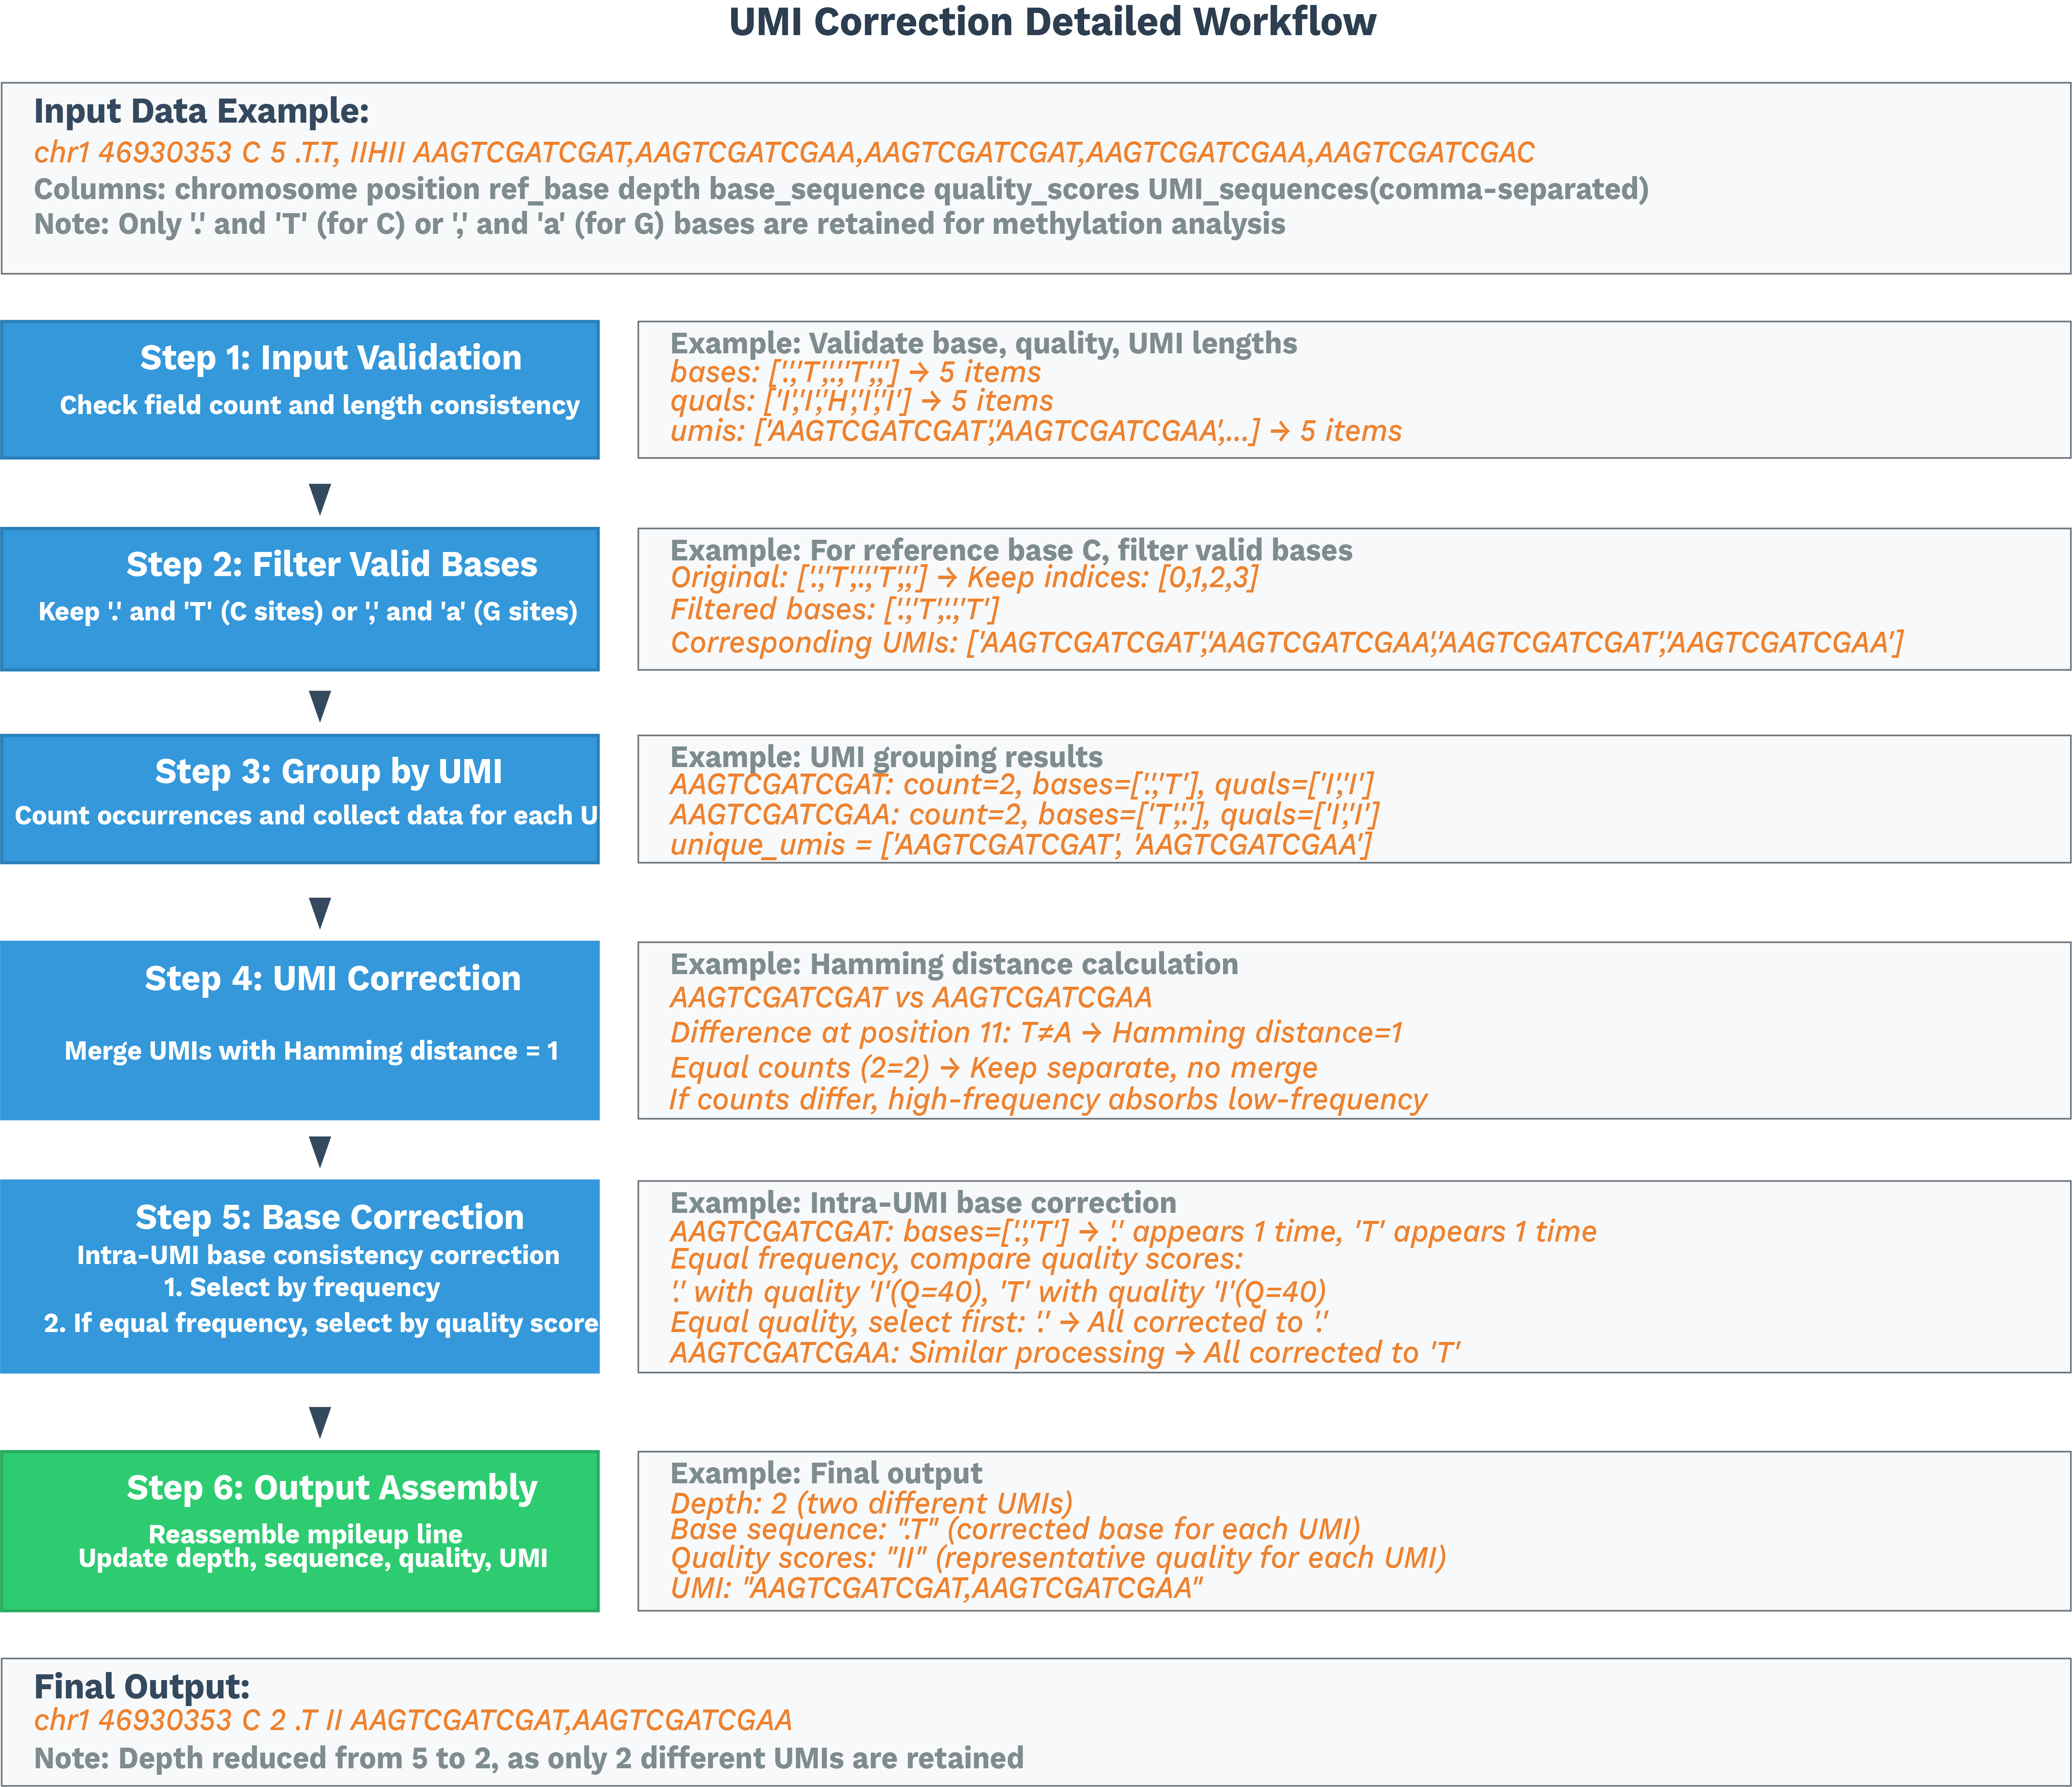
工作流按细胞 barcode 拆分按名称排序的 BAM 文件,将每个细胞的 BAM 转换为 ALLC 格式,使用定制的 ALLCools 实现执行基于 UR 标签的 UMI 处理,并构建多尺度甲基化数据集,例如 chrom10k、chrom20k、chrom50k、chrom100k、chrom500k、chrom1M 和 geneslop2k。
第 4 步:降维和可视化
默认情况下,对 chrom20k bin 执行 LSI 降维,然后进行 UMAP 可视化。
工作流摘要
在实现层面,SeekSoul Methyl Tools 的 Nextflow 流程分为四个主要的进程组:
step1:QC、转录组分析、甲基化 barcode 解析和 FASTQ 分片step2:Bismark 比对和 BAM 按名称排序step3:单细胞拆分、ALLC 生成、ALLC 合并和 MCDS 生成step4:摘要统计、聚类、可视化和综合 HTML 报告
执行环境
SeekSoul Methyl Tools 通过 Nextflow profile 选择执行环境与容器镜像:
-profile docker:使用公共容器镜像ghcr.io/seekgene/seeksoulmethyl_docker:v1.0.0-profile aliyun_k8s和-profile aliyun_k8s_argo:使用内部阿里云镜像seekgene-registry-vpc.cn-beijing.cr.aliyuncs.com/seekgene/seeksoulmethyl:1.1.2,用于 SeekGene Kubernetes 环境
Nextflow 详细步骤说明
本节捕获了自述文件中面向过程的详细描述,并将其映射回此处使用的文档结构中。
第 1 步:预处理和 Barcode 解析
COMPUTE_CPG_SITES:从genome.fa和染色体大小信息计算全基因组 CpG 位点FASTP_EXPRESSION_MULTI:执行转录组 FASTQ 修剪和 QCFASTP_METHYLATION_MULTI:在 barcode 解析前执行甲基化 FASTQ QCSEEKSOULTOOLS_RNA:运行转录组比对、计数、过滤、聚类和差异表达METHYLATION_BARCODE_EXTRACTION:根据化学类型(默认DD-MET5)解析甲基化 barcode 和 UMI,执行 barcode 校正,并可使用--split_fastq对 FASTQ 进行分片PARSE_FASTQ_FILES:将正向和反向 FASTQ 片段配对以进行下游比对FASTP_METHYLATION_BARCODE_EXTRACT:对解析后的甲基化 FASTQ 执行 barcode 提取后的 QC
第 2 步:Bismark 比对和 BAM 排序
BISMARK_ALIGNMENT_FORWARD:比对带有 barcode 和 UMI 标签的正向甲基化 readBISMARK_ALIGNMENT_REVERSE:在启用 PBAT 模式的情况下比对反向甲基化 readSORT_BAM_BY_NAME:按 read 名称对 BAM 文件进行排序,以便正确执行下游的单细胞拆分
第 3 步:单细胞拆分、ALLC 生成、合并和数据集构建
SPLIT_BAM_FILES:使用转录组派生的 barcode 将按名称排序的 BAM 拆分为单细胞 BAM 文件MERGE_BISMARK_BAM:合并正向和反向的单细胞 BAM,并组合 barcode 计数摘要ALLCOOLS_BAM_TO_ALLC:使用定制的 ALLCools 实现将单细胞 BAM 转换为 ALLC 格式MERGE_FILTERED_BARCODE_READS_COUNTS:合并 barcode 级别的指标并编写综合的细胞摘要ALLCOOLS_GENERATE_DATASETS:构建多尺度甲基化数据集,例如 chrom10k、chrom20k、chrom50k、chrom100k、chrom500k、chrom1M 和 geneslop2kALLCOOLS_SUBMERGE和ALLCOOLS_MERGE:启用 FASTQ 拆分时合并分片的 ALLC 输出ALLCOOLS_EXTRACT:提取合并的 CG 上下文 ALLC 输出用于下游分析
对于 methy_only 工作流,基于 read 计数的 barcode 估计和过滤会额外通过 utils.nf 中的辅助工具进行处理,其中细胞估计使用 --expected_cell_num 参数指定预期细胞数,默认值为 3000。
第 4 步:摘要、降维和联合报告
METHYLATION_SUMMARY:将 Bismark 报告、细胞指标和 CpG 统计数据汇总为 JSON 和 CSV 摘要METHYLATION_LSI_PCA_CLUSTERING:执行降维和聚类,默认对 chrom20k bin 使用 LSIMULTI_REPORT:将转录组和甲基化输出组合成综合 HTML 报告
参考文献
[1] Lu X, Yuan Y, et al. Improved tagmentation-based whole-genome bisulfite sequencing for input DNA from less than 100 mammalian cells. Epigenomics. 2015;7(1):47-56. doi:10.2217/epi.14.76.