Doublet.calculate 模块说明文档
时长: 5 分钟
字数: 1.4k 字
更新: 2026-10-13
阅读: 0 次
模块简介
Doublet.calculate 是单细胞(scRNA-seq / scATAC-seq / FFPE / SeekSpace)数据的双胞(Doublet)鉴定与去除模块。
背景:什么是 Doublet
基于液滴的单细胞平台(SeekOne)在细胞捕获时,一个液滴偶尔会包裹两个或多个细胞,它们共享同一个 barcode,被当作"一个细胞"测序,产生混合转录组。双细胞会导致:
- 该 barcode 的 UMI / 基因数异常偏高;
- 干扰聚类与细胞类型鉴定;
- 污染下游差异分析、细胞通讯、轨迹推断等结论;
模块作用
对每个样本的每个 barcode,判定它是 Doublet(双细胞)还是 Singlet(单细胞),输出:
- 每个 barcode 的判定标签 / 得分;
- 双胞 / 单胞统计表;
- 可视化:UMAP 双胞标记图;
- 过滤掉 Doublet、只保留 Singlet 的清洗后 Seurat 对象;
- HTML 报告。
支持两种算法,可单选或同时跑(由 type 参数控制):
| type | 算法 | 实现语言 |
|---|---|---|
DoubletFinder | 人工双胞模拟 + 聚类邻域 kNN | R(DoubletFinder 包) |
Scrublet | 人工双胞模拟 + PCA 邻域打分 | Python(scrublet 包) |
both | 两者都跑,各自出结果 | R + Python |
分析原理
两种算法思路相通:都是用真实数据"造"出一批模拟双细胞,再据此判断真实细胞里哪些更像双细胞
DoubletFinder
- 先对细胞做常规的降维与聚类,把表达相近的细胞聚到一起。
- 在这个聚类结构里,人为把两个细胞"合二为一",造出一批模拟双细胞。
- 以模拟双细胞为参照,通过近邻分析判断每个真实细胞"更像双细胞还是单细胞"。
- 同时结合细胞类型做修正,避免把本就属于同一类型的细胞误判成双细胞。
特点:结果贴合数据自身的聚类结构,但速度较慢、占用内存较大。
Scrublet
- 不依赖聚类,直接在原始表达矩阵上随机把两个细胞的表达量相加,造出一批模拟双细胞。
- 把真实细胞与模拟双细胞一起降维,计算每个真实细胞周围"有多少个模拟双细胞"。
- 这个比例就是"双细胞得分",得分越高越可能是双细胞;再自动确定一个阈值,把细胞分为双细胞 / 单细胞。
特点:速度快、内存小,但对数据质量较敏感(尤其 FFPE 石蜡样本、去污染后的数据),自动阈值有时会失灵。
两者区别
| DoubletFinder | Scrublet | |
|---|---|---|
| 模拟双细胞的位置 | 在聚类 / 降维结果里 | 在原始表达矩阵上随机合并 |
| 判断方式 | 与模拟双细胞的近邻关系 | 双细胞得分 |
| 速度 / 内存 | 较慢 / 较大 | 较快 / 较小 |
云平台参数说明
参数总览
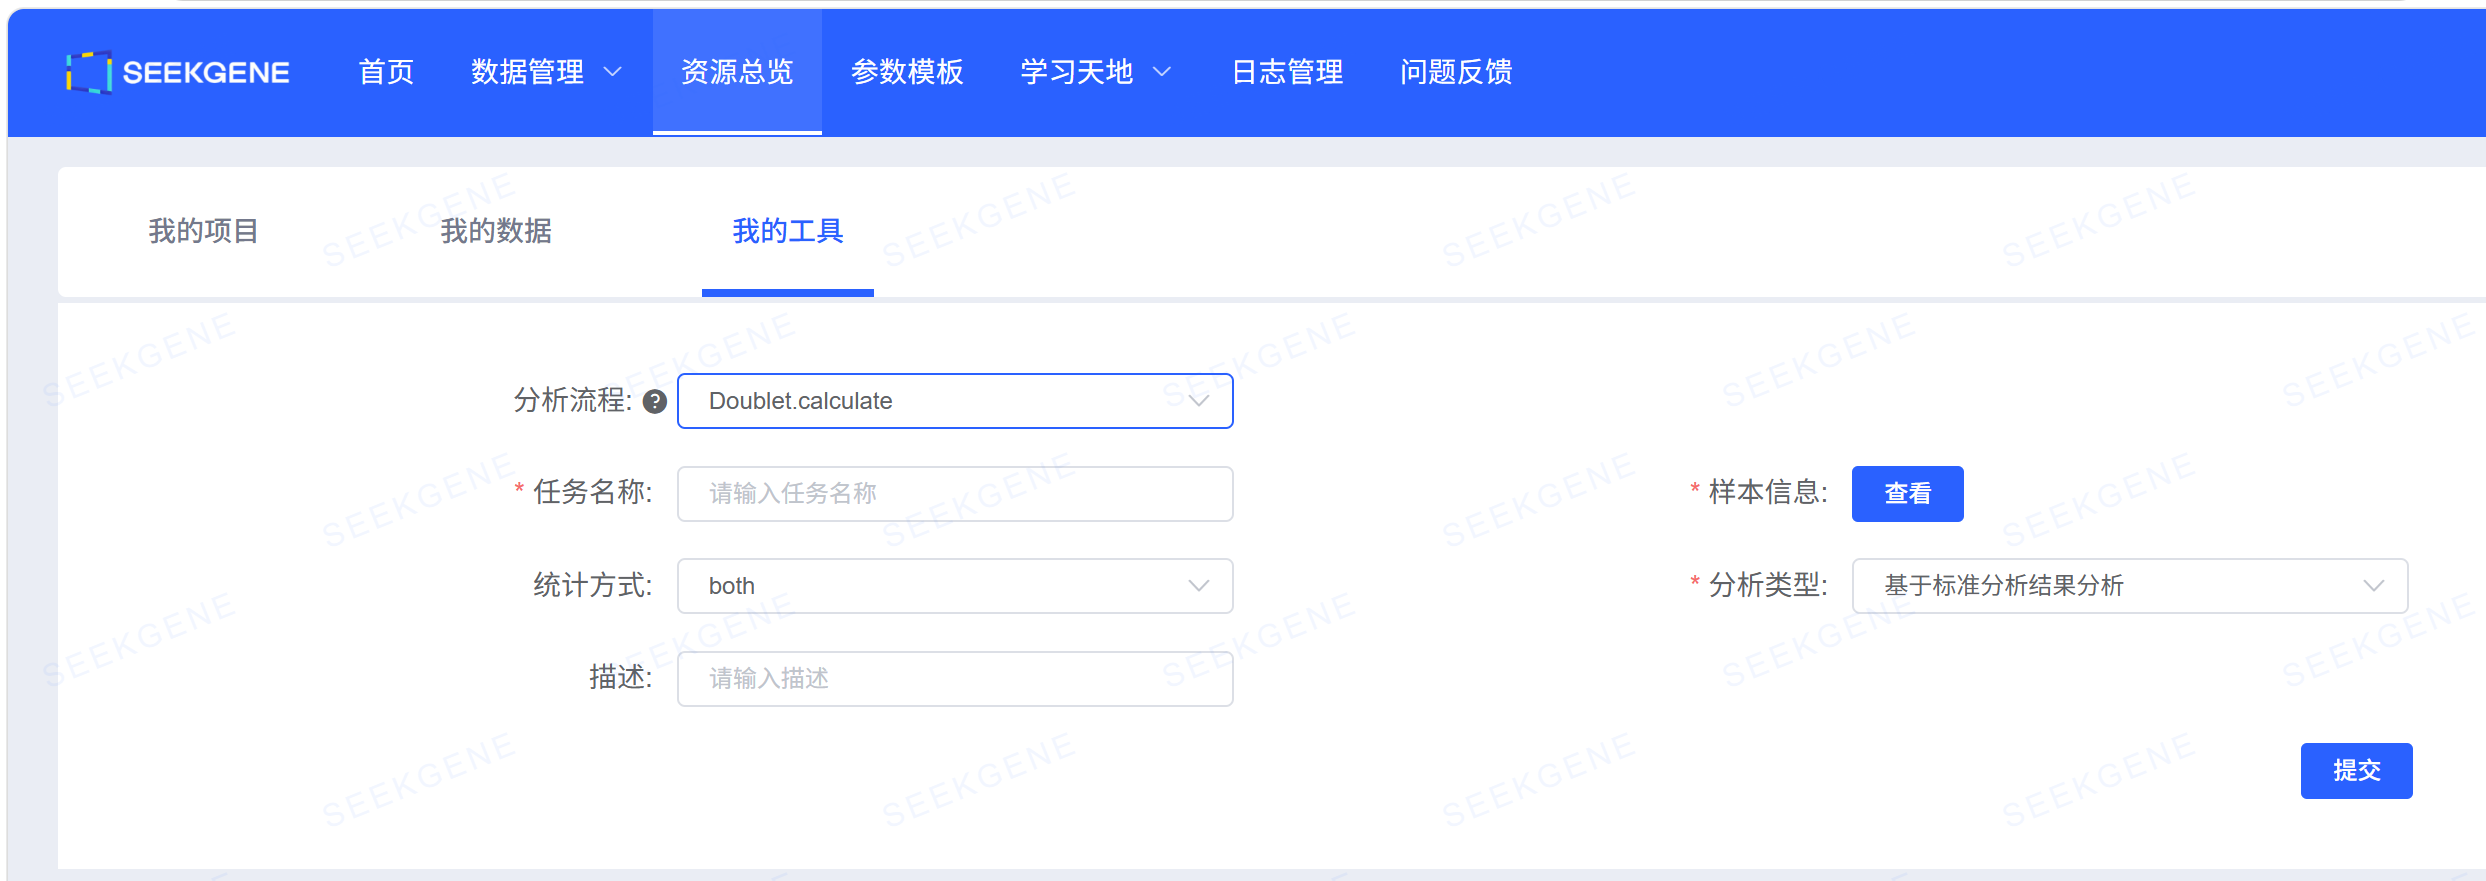
| 选项 | 是否必填 | 含义 |
|---|---|---|
| 分析流程 | 必填 | Doublet.calculate |
| 任务名称 | 必填 | 任务id,不可与历史重复 |
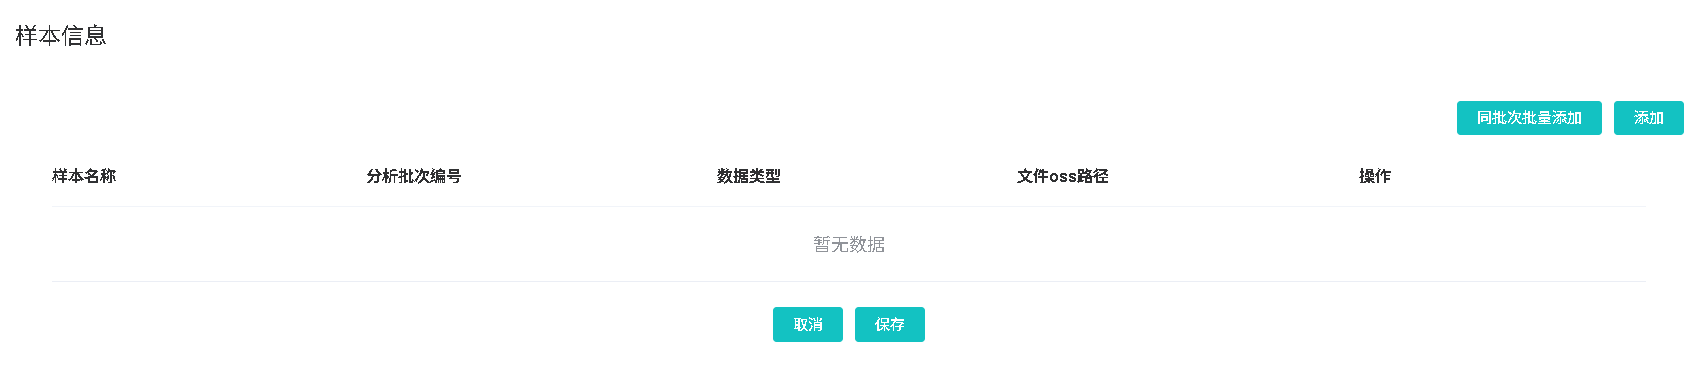
| 样本信息 | 必填 | 样本名称,其余信息(分析批次编号,数据类型,文件路径)自动填充;同一个样本可能对应多个分析批次,注意核对。 |
| 统计方式 | 必填 | 默认both(DoubletFinder + Scrublet 同时运行) |
| 分析类型 | 必填 | 默认基于标准分析结果分析,可选基于历史Soupx结果分析 、基于数据上传的结果分析 |
| 描述 | 选填 | 任务内容描述 |
WARNING
数据范围强调:本模块仅支持转录组数据。对于 SeekARC、SeekSpace 等数据,仅对其中的转录组部分进行双胞分析(SeekARC 的 ATAC 部分随结果对象保留,但不参与双胞鉴定);如 5' + VDJ 文库,仅支持 5' 转录组文库的分析,TCR/BCR 数据不可分析。
结果使用方法
- 核对双胞比例是否合理:查看
merged_DoubletFinder_table.txt或merged_Scrublet_table.txt中的percent.Doublet列。正常数据双胞率随细胞数增加而升高,数千至一万多细胞的样本通常在 2% ~ 6% 左右;若出现大量 0% 或异常偏高,需进一步核对。 - 核查双胞判定是否可信:查看每个样本的
{样本}DoubletFinder.png/{样本}Scrublet.png(UMAP 上双胞的标记位置)以及DoubletFinder_result.txt/Scrublet_result.txt(每个 barcode 的判定标签与得分),确认双胞分布合理、未大面积误判。 - 下游分析直接使用过滤后 RDS:分析完成后,过滤掉双胞的数据会自动添加至「云平台 —— 资源总览 —— 我的数据」,可以查看细胞数,确认各样本过滤后保留的细胞数合理,未出现异常骤减;核对结果后可以直接创建流程,选择对应数据进行分析。
使用注意事项
- 算法选择:默认
both会同时给出 DoubletFinder 与 Scrublet 两套结果和两套清洗后数据;若只需其一,可在"统计方式"中单选,节省约一半时间与内存。 - 输入数据来源:支持三种分析入口(基于标准分析结果 / 基于历史 SoupX 结果 / 基于数据上传结果),提交时请确认所选样本与对应的分析批次一致。
- FFPE / 去污染数据的注意点:在这类数据上,Scrublet 的自动判定有时会失灵(部分样本可能被判出 0 个双细胞),建议优先参考 DoubletFinder 的结果,并结合可视化图人工核对。