处理过程
表达文库分析
estep1: barcode/UMI 提取
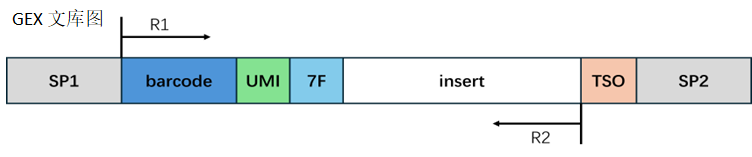
转录组文库结构:
barcode 处理:
根据结构设计,取出相应序列。当取出的 barcode 序列在白名单中时,我们认为它是有效 barcode,计入有效 barcode 的 Reads 数量;当 barcode 不在白名单中时,我们认为它是无效 barcode。
TIP
测序过程中,有一定几率发生测序错误。在提供有白名单的情况下,SeekArc Tools v1.2.0 可以尝试 barcode 矫正。在启用矫正时,当无效 barcode 一个碱基错配(一个 hamming distance)的序列存在于白名单中:
- 只有一个候选序列存在于白名单中:将该无效 barcode 矫正为对应的白名单 barcode。
- 有多个候选序列存在于白名单中:将该无效 barcode 矫正为 Reads 支持数量最多的候选 barcode。
接头处理:
在转录组中,Reads 2 的末端有可能会出现 7F 的反向互补序列,建库时可能引入的接头序列。我们对这些污染序列进行切除,剪切完的 Reads 2 长度需要大于设定的最小长度来保证有足够的信息,准确比对到基因组的位置。如果剪切完成后的 Reads 2 长度小于最小长度,我们认为这条 Reads 为无效 Reads。
estep2: 进行比对并找到比对基因
序列比对:
- SeekArc Tools v1.2.0 使用 STAR 比对软件将处理后的 R2 比对到参考基因组上。
- SeekArc Tools v1.2.0 使用 QualiMap 软件和转录本注释文件 GTF,统计 Reads 比对外显子、内含子和基因间区等的比例。
- SeekArc Tools v1.2.0 使用 featureCounts 将比对上的 Reads 注释到基因上,可以选择不同的注释规则,如链方向性和定量的 feature。当使用外显子定量时,当 Reads 超过 50% 碱基比对到外显子区域时,认为该 Reads 来源于此外显子以及外显子对应的基因;当使用转录本定量时,当 Reads 超过 50% 碱基比对到转录本区域时,认为该 Reads 来源于此转录本以及转录本对应的基因。
经过上述处理后,可得到以下主要指标:
- Reads Mapped to Genome:比对到参考基因组上的 Reads 占所有 Reads 的比例,包括唯一比对和多位置比对的 Reads。
- Reads Mapped Confidently to Genome:在参考基因组上只有一个比对位置的 Reads 占所有 Reads 的比例。
- Reads Mapped to Intergenic Regions:比对到基因间隔区 Reads 占所有 Reads 的比例。
- Reads Mapped to Intronic Regions:比对到内含子区域 Reads 占所有 Reads 的比例。
- Reads Mapped to Exonic Regions:比对到外显子区域 Reads 占所有 Reads 的比例。
estep3: 定量
UMI 定量:
SeekArc Tools v1.2.0 以 barcode 为单位读取 featureCounts 输出的 BAM 文件,统计每个基因对应的 UMI 数量及 UMI 支持的 Reads 数量。
- 过滤 UMI 为单一重复碱基的 Reads,例如 UMI 为
TTTTTTTT。 - 当 Reads 被注释到多个基因时,仅保留能够唯一确定外显子注释的 Reads,其他情况将被过滤。
UMI 矫正:
NOTE
测序过程中,UMI 也有一定概率出现测序错误。SeekArc Tools v1.2.0 默认使用 UMI-tools 的 adjacency 方法对 UMI 进行矫正。
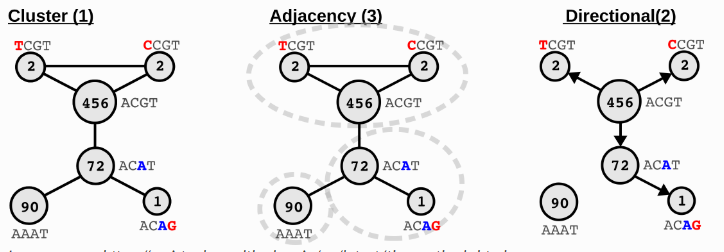
Image source: https://umi-tools.readthedocs.io/en/latest/the_methods.html
ATAC 文库分析
astep1: barcode 提取
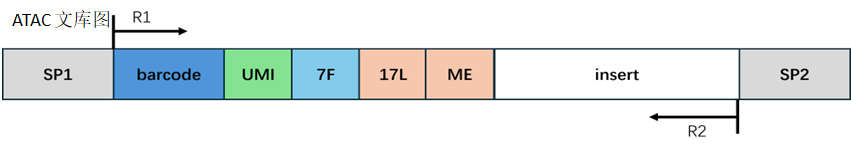
ATAC 文库结构:
barcode 处理:
同 estep1 的处理方式一样。
接头和 Reads 处理:
在 ATAC 文库中,Reads 1 带有固定序列,末端有可能会出现接头序列;Reads 2 的末端有可能会出现固定序列的反向互补序列和接头序列。我们对这些污染序列进行切除,剪切完的 Reads 1 或 Reads 2 长度需要大于设定的最小长度来保证有足够的信息,准确比对到基因组的位置。如果剪切完成后的 Reads 1 或 Reads 2 长度小于最小长度,我们认为这条 Reads 为无效 Reads;如果剪切完成后的 Reads 1 或 Reads 2 长度大于 50,则截取 Reads 1 或 Reads 2 序列的前 50bp;如果剪切完成后的 Reads 1 或 Reads 2 长度小于 50 且大于最小长度,则保留 Reads 1 或 Reads 2 的全部序列。
astep2: 进行比对
序列比对:
使用 bwa mem 将处理后的 Reads 1 和 Reads 2 比对到参考基因组上。
astep3: 定量
使用 SnapATAC2 v2.8.0 处理 astep2 输出的 BAM 文件。
- 读取 BAM,获取 ATAC 的 Sequencing 和 Mapping 相关指标。
- 由 BAM 生成原始 fragments 文件。默认过滤线粒体染色体(
chrM、M、chrMT、MT)上的 fragments;启用--keep_mito后保留线粒体 fragments。 - 由过滤后的 fragments 文件生成 AnnData 对象。
- 绘制 TSS 得分分布图。
- 使用 MACS3 进行 call peak,并过滤重复的 peaks,输出到 peaks.bed。
- 根据 peaks 生成 raw_peaks_bc_matrix。
- 统计每个 barcode 的相关指标,输出到 per_barcode_metrics.csv。
- 绘制插入片段分布图。
- 进行 RNA 与 ATAC 联合细胞判定。
- 生成 filtered_feature_bc_matrix 和 filtered_peaks_bc_matrix。
- 统计 ATAC 的 Cells、Targeting、TSS 和测序饱和度等相关指标。
细胞判定
若同时指定 --min_atac_count 和 --min_gex_count:
- 将 GEX UMI 数量大于或等于
min_gex_count,且 Peak 区域内 ATAC events 数量大于或等于min_atac_count的 barcode 判定为细胞。 - 两个参数需要同时使用,单独设置其中一个参数不会启用阈值判定。
若未同时指定上述参数,则进行自动细胞判定:
- 首先保留 GEX UMI 数量大于 1,且 Peak 区域内 ATAC events 数量大于 1 的 barcode。
- 将每个 barcode 的 fragments overlapping Peaks 比例与延伸 Peak 所占基因组比例进行比较。Peak 区域向前后各延伸 2 kb,重叠区域进行合并;仅保留 fragments overlapping Peaks 比例高于该基因组比例的 barcode。
- 根据 GEX UMI 和 Peak 区域内 ATAC events 组合去除重复值。
- 对 GEX UMI 和 ATAC events 进行
ln(x + 0.1)转换。 - 使用 K-Means 将 barcode 分为两群,两个指标中心值较高的一群判定为细胞。K-Means 使用固定随机种子,以提高重复运行结果的一致性。
- 指定
--max_cells时,如果自动识别的细胞数超过设定值,则保留与非细胞聚类中心距离较远的前 N 个 barcode;未设置时不限制自动识别细胞数。 - 启用
--strict_cell_calling后,进一步根据原始表达矩阵执行 ambient RNA 背景检验,并取该结果与 K-Means 识别结果的交集作为最终细胞。
astep4: 后续分析
经过上述步骤,得到细胞的表达矩阵和 ATAC 矩阵后,我们可以进行下一步的分析。
使用 Signac v1.14.0 将细胞的表达矩阵和 ATAC 矩阵合并为一个 Seurat object。对 RNA 数据进行归一化、高变基因筛选、降维、聚类和 marker 基因分析;对 ATAC 数据进行 TF-IDF 标准化、LSI 降维及聚类分析;最后计算 Peak 与基因之间的关联。
RNA 文库单独分析
RNA 文库单独分析沿用前述表达文库的 barcode/UMI 提取、序列比对和 UMI 定量方法。与 ARC 多组学分析不同,该流程仅使用 RNA 文库进行细胞鉴定和下游分析,不进行 ATAC 文库分析及 RNA–ATAC 联合细胞判定。
step1: barcode/UMI 提取
barcode/UMI 提取、barcode 矫正及接头处理方式同 estep1。
处理完成后,生成用于后续比对的 FASTQ 文件。
step2: 进行比对并找到比对基因
序列比对和基因注释方式同 estep2。
默认将处理后的 Reads 2 以单端模式比对到参考基因组,同时也支持使用处理后的 Reads 1 和 Reads 2 进行双端比对。双端比对时,对 Reads 1 和 Reads 2 进行同步过滤,任意一端不满足要求时,将同时过滤对应的 read pair。
使用 STAR 完成序列比对,使用 QualiMap 统计 Reads 在外显子、内含子和基因间区等区域的分布,并使用 featureCounts 将比对上的 Reads 注释到基因上。
step3: UMI 定量和细胞鉴定
UMI 定量和矫正方式同 estep3。定量完成后生成 raw_feature_bc_matrix,并根据各 barcode 的基因表达 UMI 数量进行细胞鉴定。
细胞鉴定主要包括以下步骤:
- 根据 UMI 数量筛选高表达 barcode,形成初始细胞集合。
- 使用低 UMI barcode 估计环境 RNA 背景表达谱。
- 对候选 barcode 进行环境 RNA 背景检验。
- 将通过背景检验的候选 barcode 与初始细胞集合合并,得到最终细胞集合。
- 也支持按照 UMI 数量排序,直接选取指定数量的高 UMI barcode 作为细胞。
根据最终细胞 barcode 生成 filtered_feature_bc_matrix,并统计细胞数、每细胞基因数、UMI 数、测序饱和度等质量控制指标。
step4: 后续分析和结果汇总
使用过滤后的表达矩阵生成 Seurat 对象,计算线粒体基因比例,并依次进行表达矩阵归一化、高变基因筛选、数据标准化、PCA、邻居计算、聚类、t-SNE 和 UMAP 降维分析以及 marker 基因筛选。最终保存 Seurat RDS,输出细胞降维坐标、UMI 信息和 marker 基因结果,并汇总 RNA/GEX 测序、比对、定量及细胞相关的质量控制指标。